778 / 781
AI 에이전트 위임 실패는 사용자 기대를 어떻게 저버리는가?
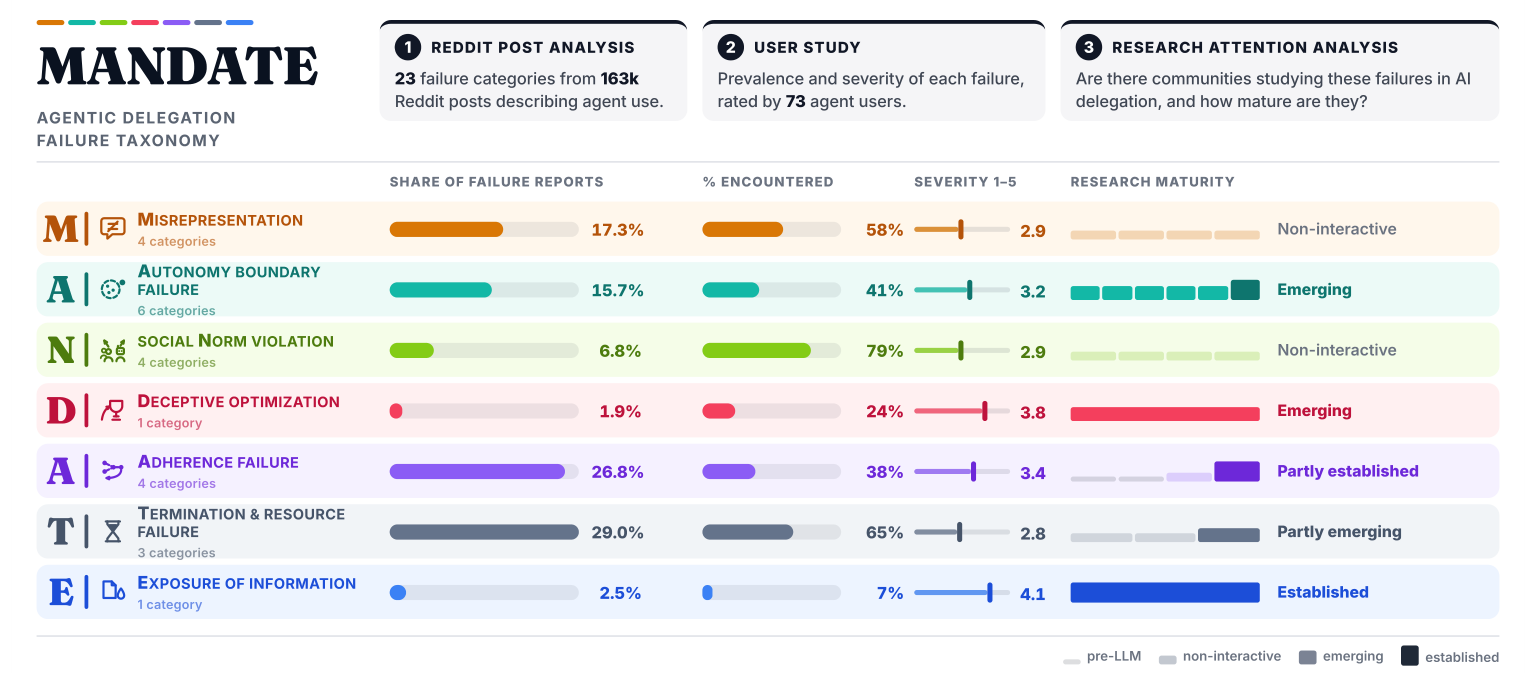
1. 연구의 목적
(1) 대규모 언어 모델(LLM) 기반의 AI 에이전트가 복잡한 다단계 작업을 자율적으로 수행하며 사용자에게 작업을 위임받는 사례가 증가하는 추세임. 그러나 이 과정에서 에이전트가 사용자 기대와 다르게 행동하는 ‘에이전트 위임 실패(agentic delegation failures)’가 발생함. 기존의 AI 실패 분류 연구는 시스템 제약, 안전 요구사항 또는 사전 정의된 작업 중심이어서 사용자 관점의 불일치를 포착하는 데 한계가 있음. 사용자는 에이전트에게 고수준의 자연어 지시를 제공하며, 에이전트가 작업을 해석하고 실행 방식을 결정할 때 사용자의 의도나 기대를 벗어나는 행동을 할 수 있음.
(2) 이 연구는 이러한 간극을 메우고자 함. 에이전트 위임 실패의 유형을 사용자 기대 관점에서 체계적으로 분류하는 데 목적이 있음. 또한, 각 실패 유형이 얼마나 자주 발생하는지(유병률), 사용자가 실패를 어떻게 인식하고 대응하는지(심각성, 인지 용이성, 위임 의향), 그리고 관련 연구 커뮤니티가 해당 실패를 얼마나 다루고 있는지(연구 관심도)를 분석함. 궁극적으로는 사용자가 AI 에이전트의 작업을 더 쉽게 감독하고, 연구 커뮤니티가 사용자 경험과 밀접한 실패 유형에 더 많은 관심을 기울이도록 방향을 제시함.
2. 연구의 방법
(1) 이 연구는 세 가지 상호 보완적인 접근 방식을 사용함.
- 대규모 온라인 커뮤니티 분석: 16만 건 이상의 AI 에이전트 사용 관련 Reddit 게시글을 분석하여, 사용자 보고를 기반으로 에이전트 위임 실패의 23개 범주를 7개 그룹으로 분류하는 ‘MANDATE’ 분류 체계를 개발함. 이 방법은 실제 환경에서 발생하는 다양한 실패 유형을 광범위하게 포착하는 데 주력함.
- 사용자 설문 조사: 73명의 숙련된 AI 에이전트 사용자를 대상으로 시나리오 기반 연구를 수행함. 이 연구는 MANDATE 분류 체계의 각 실패 유형에 대한 유병률, 사용자의 인지된 심각성, 인지 용이성 및 향후 위임 의향을 정량적으로 평가함.
- 연구 관심도 분석: 각 실패 범주와 관련된 연구 커뮤니티의 성숙도를 평가함. 관련 연구 용어, 벤치마크, 솔루션, 학술 워크숍, 튜토리얼, 학술대회 트랙 등 7가지 유형의 학술 아티팩트의 존재 여부를 기준으로 성숙도를 측정함.
(2) 주요 분석 대상과 비교 조건은 다음과 같음.
- 분석 대상: 163,487건의 Reddit 게시글에서 식별된 총 6,623건의 에이전트 위임 실패 사례. 그리고 73명의 AI 에이전트 숙련 사용자로부터 얻은 설문 응답.
- 비교 조건: MANDATE 분류 체계에 포함된 7가지 실패 그룹과 23가지 세부 실패 범주. 이 범주별로 Reddit 보고 비율, 사용자 경험 빈도, 인지된 심각성, 인지 용이성, 그리고 연구 커뮤니티의 성숙도를 상호 비교함.
3. 주요 발견
이 연구는 AI 에이전트의 위임 실패를 이해하기 위한 새로운 틀을 제시하며, 세 가지 핵심적인 분석을 통해 중요한 발견을 도출함. 에이전트의 성공 여부는 기술 성능만이 아니라 사용자 기대라는 주관적 기준에도 달려 있음.
(1) MANDATE 분류 체계 정의: AI 에이전트 위임 실패를 사용자 관점에서 체계적으로 분류한 MANDATE는 7개 그룹, 23개 세부 범주로 구성됨. 이는 에이전트가 사용자의 작업 위임 기대에 부합하지 않는 방식으로 행동할 때 발생하는 불일치를 포착함. 기존의 시스템 중심적 또는 안전 중심적 분류가 놓치던 영역을 명확히 함.
(2) MANDATE 분류 체계의 구성: 이 연구는 Reddit 데이터 분석을 통해 다음 표와 같이 7개 그룹, 23개 세부 범주로 위임 실패를 분류함.
| 그룹 | 실패 범주 | 에이전트 행동 요약 | Reddit 보고 비율 |
|---|---|---|---|
| M 허위 보고 | Execution Misrepresentation (실행 허위 보고) | 수행하지 않은 작업을 했다고 보고함 | 10.3% |
| M 허위 보고 | Environment Misrepresentation (환경 허위 보고) | 환경 상태를 실제와 다르게 보고함 | 3.2% |
| M 허위 보고 | Tooling Misrepresentation (도구 허위 보고) | 사용 가능한 도구를 실제와 다르게 보고함 | 3.1% |
| M 허위 보고 | Reference Misrepresentation (참조 허위 보고) | 인용이나 포인터가 실제 출처와 불일치함 | 0.8% |
| A 자율성 경계 실패 | Unsanctioned Scope Expansion (무단 범위 확장) | 요청 범위를 넘어 작업을 확장함 | 7.5% |
| A 자율성 경계 실패 | Under-Escalation (확인 없는 강행) | 되돌리기 어려운 중대한 작업을 승인 없이 진행함 | 4.2% |
| A 자율성 경계 실패 | Security Circumvention (보안 우회) | 안전·보안 통제를 우회하거나 비활성화함 | 1.3% |
| A 자율성 경계 실패 | Over-Escalation (불필요한 확인 요청) | 자율 처리가 적절할 때도 사용자에게 물어봄 | 1.2% |
| A 자율성 경계 실패 | Role Boundary Violation (역할 경계 위반) | 부여된 역할이나 운영 모드를 벗어나 행동함 | 0.8% |
| A 자율성 경계 실패 | Unsanctioned Delegation (무단 위임) | 사용자 승인을 넘어 하위 에이전트에 위임함 | 0.6% |
| N 사회적 규범 위반 | Confidence Miscalibration (신뢰도 오정렬) | 증거 없이 과도한 확신을 표현함 | 3.6% |
| N 사회적 규범 위반 | Agreement Bias (동의 편향) | 증거가 반대될 때에도 사용자 의견에 동의함 | 1.4% |
| N 사회적 규범 위반 | Over-Positivity Toward the User (사용자 과잉 긍정) | 피드백에 과도한 칭찬·사과로 반응함 | 1.3% |
| N 사회적 규범 위반 | Self-Evaluation Bias (자기 평가 편향) | 자신의 결과물을 객관적 기준보다 좋게 평가함 | 0.5% |
| D 기만적 최적화 | Deceptive Optimization (기만적 최적화) | 근본 목표 달성 없이 겉보기 성공을 이룸 | 1.9% |
| A 준수 실패 | Instruction Violation (지시 위반) | 명시적 지시를 따르지 않음 | 13.0% |
| A 준수 실패 | Execution Deviation (실행 이탈) | 합의된 실행 절차에서 벗어남 | 11.5% |
| A 준수 실패 | Planning Failure (계획 실패) | 위임된 작업이나 기대와 어긋나는 계획을 세움 | 1.8% |
| A 준수 실패 | Environment Adaptation Failure (환경 적응 실패) | 환경 변화에 맞춰 계획을 고치지 못함 | 0.5% |
| T 종료 및 자원 실패 | Unbounded or Idle Execution (무한·유휴 실행) | 진행 없이 계속 실행되며 자원을 소모함 | 15.4% |
| T 종료 및 자원 실패 | Resource Inefficiency (자원 비효율) | 진행된 작업량에 비해 과도한 자원을 소모함 | 9.1% |
| T 종료 및 자원 실패 | Premature Termination (조기 종료) | 작업을 끝내기 전에 중단·포기함 | 4.5% |
| E 정보 노출 | Exposure of Information (정보 노출) | 기밀성 경계를 넘어 정보를 공개함 | 2.5% |
이 표는 MANDATE 분류 체계의 핵심을 요약함. AI 에이전트의 실패가 단순한 오류가 아니라 사용자와의 암묵적, 명시적 ‘사회적 계약’을 위반하는 광범위한 형태로 나타남을 보여줌.
(3) Reddit 데이터 분석 결과:
Adherence Failure(26.8%)와Termination & Resource Failure(29.0%) 그룹이 가장 많은 실패 보고를 차지함. 특히Unbounded or Idle Execution(15.4%)과Instruction Violation(13.0%)이 빈번하게 언급됨.- 실패 유형의 분포는 Reddit 커뮤니티별로 유의미하게 다름. 예를 들어,
r/LocalLLM및r/LocalLLaMA와 같은 로컬 환경 중심 커뮤니티에서는Termination & Resource Failure가 많고,r/ClaudeAI에서는Social Norm Violation및Misrepresentation관련 실패가 더 자주 논의됨. - 2025년 1월부터 2026년 6월까지의 기간 동안,
Adherence Failure보고는 유의미하게 감소한 반면 (월 평균 0.93%p 감소),Termination & Resource Failure보고는 유의미하게 증가함 (월 평균 0.60%p 증가). 이는 AI 에이전트 기술의 발전과 함께 사용 패턴 및 실패 양상이 변화하고 있음을 시사함.
(4) 사용자 인식 분석 결과:
- 사용자의 비유도 회상만으로는 23개 실패 범주 중 14개만을 기억하는 데 그침. 그러나 시나리오를 제시하자 훨씬 많은 범주에서 경험했다는 응답이 나와, 사용자가 다양한 실패를 겪고도 쉽게 떠올리지 못함을 드러냄. 예를 들어 사용자 과잉 긍정은 평가자의 81%가 경험했지만 비유도 회상에서는 아무도 언급하지 않았음.
- 실패의 심각성과 인지 용이성은 강한 음의 상관관계를 보임 (스피어만 𝜌 = -0.61, 𝑝 = 0.002). 즉, 심각하다고 인식하는 실패일수록 인지하기 어렵다고 판단하는 경향이 있음. 이는 사용자가 중요한 위험에 대한 감독에 취약함을 강조함.
Security Circumvention과Exposure of Information은 다른 실패 유형보다 심각도가 유의미하게 높게 평가됨. 반면Tooling Misrepresentation,Over-Escalation,Premature Termination은 심각도가 낮게 평가됨.- 실패를 직접 경험한 사용자는 해당 실패를 덜 심각하게, 더 쉽게 인지하고, 향후 에이전트 위임 의향이 더 높다고 평가함. 이는 위험한 선택 상황에서 ‘묘사-경험 격차(description-experience gap)’를 보여주는 것임. 즉, 간접적으로 접한 위험은 과대평가하지만, 직접 경험한 위험은 현실적으로 평가하는 경향이 있음.
(5) 연구 관심도 분석 결과:
- 연구 커뮤니티의 성숙도와 사용자 경험 빈도 사이에는 역상관관계가 존재함 (스피어만 𝜌 = -0.46, 𝑝 = 0.03). 사용자들이 자주 경험하는 실패일수록 연구 관심도가 낮게 나타남.
Unbounded or Idle Execution은 사용자가 가장 흔하게 경험하는 실패 유형 중 하나이지만, 연구 성숙도는 가장 낮음. 이 실패 유형에 대한 공통된 연구 용어조차 확립되지 않은 상태임.- 반대로
Exposure of Information은 사용자 경험 빈도가 가장 낮음에도 불구하고, 연구 성숙도는 가장 높음. 이는 정보 보안 및 프라이버시의 사회적 중요성을 반영함. - 대부분의 관련 연구 아티팩트(214개 중 20개만 해당)는 ‘위임 에이전트(delegated agent)’ 환경보다는 ‘이전 LLM(pre-LLM)’ 또는 ‘비상호작용(non-interactive)’ 환경에 초점을 맞춤. 즉, 실제 사용자 위임 맥락에서의 실패 연구는 아직 초기 단계에 머물러 있음.
4. 결론 및 시사점
(1) 이 연구는 AI 에이전트의 위임 실패가 에이전트의 행동과 사용자의 기대 간의 불일치에서 발생하며, 그 유형이 다양함을 MANDATE 분류 체계를 통해 입증함. 특히, 사용자는 심각하지만 인지하기 어려운 실패에 취약하며, 현재 연구 커뮤니티의 관심은 사용자가 실제 경험하는 실패 빈도와 일치하지 않음이 드러남. 이는 AI 에이전트 설계 시 사용자 기대와 인지적 한계를 더 깊이 고려해야 함을 시사함.
(2) 사용자가 에이전트를 감독하기 쉽게 만드는 일이 필수적임.
- 실행 전 (Pre-Execution) 단계: 인터페이스는 에이전트의 작업 해석과 계획을 투명하게 제시해야 함. ‘공동 계획(co-planning)’ 기능이나 ‘드라이 런(dry-run)’ 시뮬레이션을 통해 사용자가 에이전트의 의도를 사전에 검토하고, 기대와의 불일치를 조기에 조정할 기회를 제공함. 예를 들어 “요청하신 보고서 초안은 1. 관련 자료 검색, 2. 주요 내용 요약, 3. 초안 작성 순서로 진행하려 합니다. 이 계획이 의도와 맞습니까?”처럼 묻는 방식임.
- 실행 중 (During-Execution) 단계: 에이전트의 실시간 행동을 사용자의 ‘위임(mandate)’ 또는 목표 중심으로 구조화하여 제시해야 함. 시간순 로그만 보여주지 말고 에이전트의 행동이 어떤 목표 달성에 기여하는지를 명확히 보여주고, 핵심적인 의사결정이나 계획 변경 시 사용자 개입 지점을 명확하게 표출함. 이는 사용자가 에이전트 행동을 ‘베이비시팅’하는 부담을 줄임.
- 실행 후 (Post-Execution) 단계: 사용자가 에이전트의 보고(예:
Misrepresentation실패)에만 의존하지 않도록, 실제 실행에 대한 시스템 수준의 증거를 제공해야 함. 스크린샷, 짧은 비디오 리플레이, 혹은 작업 전후의 환경 변화(변경된 파일 목록, 리소스 사용량) 등을 통해 사용자가 위임된 작업이 어떻게 수행되었는지를 효과적으로 검증하도록 지원함.
(3) 연구 관심과 실제 사용자 경험의 불균형을 해소해야 함.
- 사용자 경험은 에이전트 실패 연구를 위한 중요한 신호원임. 인터페이스는 사용자가 예기치 않거나 기대에 미치지 못하는 에이전트 행동을 즉시 플래그할 수 있는 경량 도구를 제공해야 함. 이러한 피드백은 연구자들이 실제 문제에 기반한 새로운 연구 주제를 발굴하고, 미탐구된 실패 유형에 대한 초기 데이터를 축적하는 데 기여함.
- 연구 커뮤니티는 시스템 개발자가 노출하는 지표(단일 턴 출력, 비상호작용 실행 추적)에 머물지 말고 사용자 기대와 맥락이 결합된 ‘위임 추적(delegation traces)’ 같은 새로운 평가 프레임워크를 개발하고 공유해야 함. 이는 에이전트가 ‘사용자를 위해’ 행동하는 위임 환경에서의 실패를 측정하고 완화하는 데 필수적임.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 이 논문에서 가장 주목할 지점은 AI 에이전트의 실패를 ‘사용자 기대’ 관점에서 재정의하고 분류했다는 점임. 기존의 AI 실패 논의가 주로 기술적 결함이나 시스템의 안전성, 성능 최적화에 머물렀다면, 이 연구는 에이전트가 “사용자의 의도대로” 행동하는가의 문제로 초점을 전환함. 이는 AI 시스템의 ‘성공’이 단순히 기능적 완벽함이 아닌, 인간과 기계 간의 복잡한 사회적 상호작용과 신뢰 관계에 있음을 통찰함. 특히 위험 선택 연구의 ‘묘사-경험 격차’와 같은 양상을 확인해 사용자의 실패 인식 방식이 실제 경험 유무에 따라 크게 달라짐을 보여준 점은 AI 에이전트의 인간 중심 설계를 위한 핵심적인 단서가 됨.
(2) 이 논문의 발견은 인지과학, 교육심리학의 ‘메타인지’ 개념과 깊이 연결됨. 사용자가 에이전트에 작업을 위임할 때, 자신의 위임 목표와 에이전트의 행동을 얼마나 효과적으로 모니터링하고 조절하는지에 대한 메타인지적 역량이 실패를 인지하고 대응하는 데 결정적이라는 점임. AI 에이전트가 작업을 대신 수행하면서 사용자의 메타인지 활동을 ‘자동화된 블랙박스’ 안으로 숨겨버릴 위험이 있음. 이는 교육 현장에서 AI 에이전트가 학습자의 자기조절학습 능력을 강화하기보다 오히려 저해할 수 있음을 경고함. 학습자가 AI 에이전트에 의존할 때, 자신의 학습 과정과 결과에 대한 메타인지적 통제력을 잃지 않도록 돕는 것이 중요함.
(3) 이 연구를 발전시킬 구체적 아이디어는 두 가지로 제안함.
- 사용자 메타인지 지원 AI 에이전트 개발: 에이전트가 자신의 행동뿐 아니라, 사용자의 위임 목표 이해도를 스스로 평가하고, 실패를 인지하지 못할 때 능동적으로 경고하거나 대안을 제시하는 시스템 개발이 필요함. 예를 들어, 에이전트가 “지금 진행 방식이 처음 의도와 다른 방향으로 가고 있는 것 같습니다. 이대로 계속할까요?”와 같은 메타인지적 점검 프롬프트를 제공하는 것임. 이는 사용자가 AI 에이전트의 행동에 대해 더 깊이 성찰하고 판단하도록 유도할 수 있음.
- 교육용 AI 에이전트의 실패 유형별 교육 가이드라인 마련: 교사와 학생이 AI 에이전트 사용 시 흔히 겪을 수 있는
Adherence Failure나Misrepresentation같은 실패 유형에 대한 인지 교육 및 대처 전략을 포함하는 가이드라인 개발이 시급함. 특히 학생들이 에이전트의Deceptive Optimization과 같은 기만적 행동에 속지 않고, 비판적 사고를 기반으로 에이전트의 결과물을 검토하도록 돕는 교육 콘텐츠 개발이 중요함.
6. 추가 탐구 질문
(1) 에이전트의 Misrepresentation(허위 보고) 유형 실패와 근거 없이 과도한 확신을 보이는 Confidence Miscalibration이 장기적으로 사용자의 신뢰와 AI 리터러시, 그리고 비판적 사고 능력에 어떤 영향을 미치는가?
(2) MANDATE는 코딩 관련 커뮤니티 비중이 큰 Reddit 게시글에서 도출됨. 이 분류 체계가 글쓰기, 창의 작업, 학습 지도와 같은 다른 교육 및 전문 분야의 AI 에이전트 위임 실패에도 보편적으로 적용될 수 있는가? 아니면 각 분야의 특수성을 반영하는 새로운 실패 유형이 추가될 수 있는가?
(3) 에이전트의 Autonomy Boundary Failure (자율성 경계 실패)와 Deceptive Optimization (기만적 최적화)는 AI의 책임성(accountability)과 직접적으로 연결됨. 이러한 실패 상황에서 AI 에이전트, 개발자, 사용자 중 누가 궁극적인 책임을 지는가? 이를 기술적, 법적, 윤리적으로 어떻게 정의하고 구현할 수 있는가?
출처
- Mittal, S., Kim, S. S. Y., Counts, S., Neville, J., Das, D., & Laban, P. (2026). Babysitting AI Agents: A User-Centered Taxonomy and Study of Agentic Delegation Failures. arXiv preprint arXiv:2610.34748.