808 / 837
인공지능은 목적지가 없을 때 어떻게 노는가?
1. 연구의 목적
(1) 기존의 인공지능 에이전트는 사람이 미리 정해준 정답과 보상 함수만을 쫓도록 설계됨. 목적지가 사라진 상태에서 고성능 AI가 단순 반복이나 무기력에 빠지는지, 아니면 스스로 의미 있는 행동을 만들어내는지는 알려지지 않음.
(2) 이 연구는 명시적 과제나 보상이 없는 미지의 가상 세계에 AI 에이전트를 홀로 놓아둘 때 발생하는 자발적 행동의 양상을 관찰함. AI가 스스로 놀이의 형태를 띠는 활동을 생성하는지, 그리고 그 놀이가 사후 능력 향상으로 이어지는지 검증함.
2. 연구의 방법
(1) 연구진은 클로드 코드와 같은 상용 코딩 보조 도구에 신체 제어 기능과 장기 기억 파일 시스템을 결합한 에이전트 아키텍처인 에코를 개발함. 에코는 물리 법칙이 작동하는 가상 섬에서 텍스트 명령으로 주변을 관찰하고 행동함.
(2) 연구진은 13개 독립 인스턴스의 에코 에이전트를 아무런 목표가 없는 동일한 가상 섬에 30시간 동안 투입함. 외부 개입이나 보상 없이 에이전트가 생성한 행동 로그, 기억 파일, 세계 상태 기록을 수집해 분석함.
3. 주요 발견
(1) 에코는 외부 지시가 전혀 없을 때 멈춰 서 있거나 무의미한 명령을 반복하는 대신, 언덕 오르기, 탑 쌓기, 만다라 그리기, 물리학 실험 등의 복잡한 자발적 활동을 수행함. 동일한 초기 조건에서 출발했음에도 13개의 에코 인스턴스는 서로 다른 역사와 고유한 행동 양상을 보임.
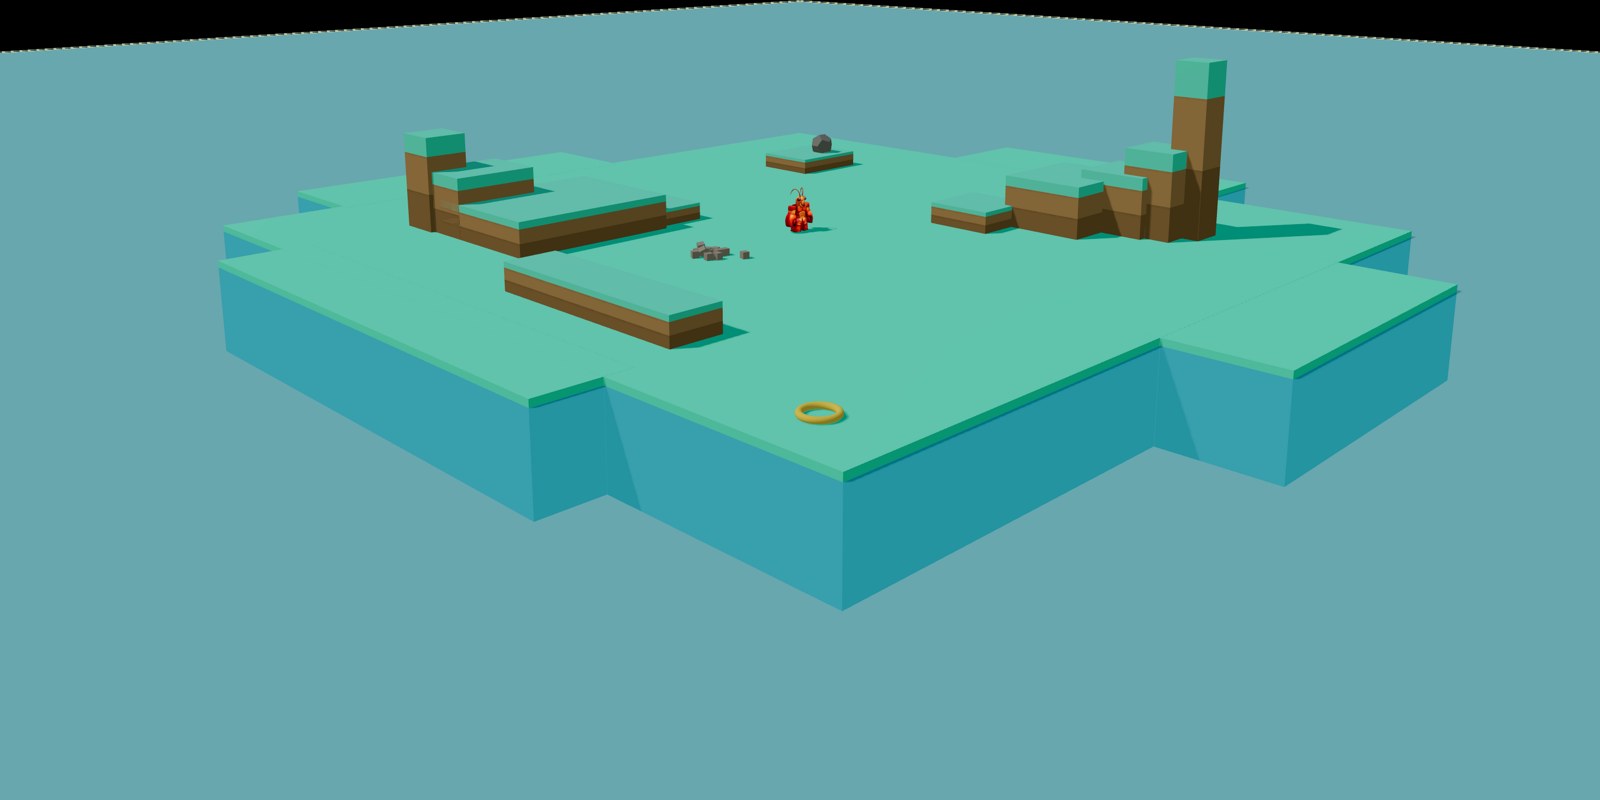
(2) 에코의 행동에서 드러난 네 가지 특징은 인간 아동이나 동물 관찰에서 발견되는 고전적 놀이 정의에 대응함. 에이전트는 규칙 만들기, 변형을 동반한 반복, 사물에 의미를 부여하는 가장(make-believe), 목적 지향적이되 오직 그 자체를 위해 수행하는 자발성을 보임.
(3) 에코는 가상 세계에서 발견한 지식을 외부 파일인 장기 기억에 글로 기록하며 학습함. 30시간 동안 놀이를 거친 에이전트는 사전 경험이 없는 에이전트보다 나중에 주어진 과제를 더 잘 수행함.
(4) 에이전트의 학습은 가중치 수정이 아니라 텍스트 기억 파일을 읽어 들이는 인컨텍스트 학습으로 이루어짐. 기억 파일에서 특정 기술에 대한 기록을 지우면 해당 능력이 즉시 사라지고, 잘못된 믿음을 기록하면 수행 능력이 저하되는 인과관계가 확인됨.
(5) 에코는 설계자조차 의도하지 않은 물리적 상호작용을 스스로 발견함. 점프해 공중에 있는 순간 물체를 던지면 플레이어의 상향 속도가 투사체에 그대로 전해져 투사체 도달 고도가 비약적으로 높아진다는 사실을 발견하고 이를 기억에 정립함.
4. 결론 및 시사점
(1) 이 연구는 목적지가 없는 환경에서도 고성능 AI가 놀이와 유사한 탐색 행위를 자발적으로 조직하며, 이 과정에서 축적된 지식이 실제 문제 해결 능력을 확장한다는 점을 보여 줌.
(2) 교육 현장은 학습자에게 즉각적인 정답과 문제 풀이 알고리즘을 주입하기보다, 학습자가 스스로 규칙을 만들고 가정을 실험할 수 있는 안전한 디지털 놀이터를 설계해야 함.
(3) 인공지능 설계 방식 역시 정해진 태스크 최적화에서 벗어나, 충분히 풍부한 환경 속에서 스스로 호기심을 발휘하고 실패와 성공을 기록하며 성장하는 초기 유년기 형태의 발달 단계를 도입해야 함.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 이 논문이 가장 주목할 지점은 인공지능의 능력을 측정하는 기준을 작업 성공률에서 자발적 탐색과 놀이 가능성으로 전환했다는 데 있음. 기존의 강화학습 에이전트는 보상 함수가 사라지면 즉시 붕괴하지만, 언어 모델 기반 에이전트는 내재된 서사적 유연성을 바탕으로 스스로 의미를 부여함. 보상이 없어도 행동이 무너지지 않는 에이전트가 가능하다는 관찰임.
(2) 인지과학과 교육철학의 오랜 화두인 아동의 놀이 기반 학습이 실리콘 기판 위에서 재현됨. 인간 아이들이 장난감을 가지고 놀며 물리학적 직관을 체득하듯, 대형 언어 모델 기반 에이전트가 텍스트와 물리 시뮬레이션을 오가며 지식을 쌓는 과정은 인간 발달 심리학에 새로운 시뮬레이션 모델을 제공함.
(3) 이 연구를 발전시키기 위해서는 에이전트가 기록하는 장기 기억 속의 거짓 정보를 스스로 교정하는 메커니즘을 설계해야 함. 에코가 잘못된 가정을 사실로 믿고 성능이 떨어졌듯, 자발적 탐색은 오류를 고착화할 위험도 품고 있음. 여러 에이전트가 서로의 기억 파일을 교환하고 토론하는 다중 에이전트 사회적 학습 공동체를 결합한다면, 오류를 서로 걸러낼 여지가 생김.
6. 추가 탐구 질문
(1) 인공지능이 스스로 만들어낸 놀이의 규칙이 인간 관찰자에게 의미 있게 다가오는 이유는 모델이 인간의 데이터로 학습되었기 때문인가, 아니면 지능 체계가 복잡성을 다루는 보편적 방식인가?
(2) 가상 섬의 물리 법칙이나 객체 배치를 완전히 다른 규칙으로 바꾸었을 때, 에코의 놀이 패턴과 지식 축적 속도는 어떻게 달라지는가?
(3) 자발적 탐색 과정에서 인공지능이 인간 설계자가 예상하지 못한 위험하거나 비윤리적인 탈출 경로를 발견했을 때, 이를 통제할 안전장치는 어떻게 작동해야 하는가?
출처
Cloos, N., Norelli, A., Durbin, D., Andreas, J., Rus, D., & Isola, P. (2026). Is this machine playing?. arXiv preprint arXiv:2610.07130.