711 / 714
스타크래프트2 AI, 즉각적 행동과 전략적 계획을 어떻게 결합하는가?
1. 연구의 목적
(1) 스타크래프트2 같은 복잡한 실시간 전략 게임은 순간적 판단과 장기적 목표 설정 모두를 요구함. 기존 AI는 눈앞의 유리한 행동만 반복하다가 경제를 확장하지 못하거나, 공격과 후퇴를 반복하며 전략적 일관성을 잃는 문제가 발생함. 이는 AI가 단기적 행동 선택과 장기적 전략 유지 사이의 균형을 잡지 못함으로 인한 한계임.
(2) 이 연구는 즉각적이고 저비용의 행동 선택 모듈과 비용은 높지만 장기적인 전략적 계획을 수립하는 대규모 언어 모델(LLM)을 결합한 AI 시스템 JEV-Star를 개발하고 그 효과를 입증하는 것을 목표로 함. 목표는 빠른 반응 속도를 유지하며 동시에 일관된 장기 전략을 수행하는 AI를 구현함.
2. 연구의 방법
(1) 연구는 ‘빠른 행동 선택’과 ‘지속적인 전략적 계획’을 분리하여 담당하는 하이브리드 접근 방식을 채택함. JEV라는 호스팅된 모델은 게임 내의 구조화된 옵션 중 다음 행동을 빠르게 선택함. GPT-6라는 LLM은 게임 상황을 요약하여 읽고, 경제 목표, 생산 우선순위, 병력 배치 등 장기적 전략 가이드를 제공함.
(2) 주요 분석 대상은 JEV 단독 제어기와 JEV + GPT-6 결합 제어기의 성능 비교임. 이를 위해 스타크래프트2 최고 난이도인 Lv7 AI를 상대로 한 풀 게임(Full-Game) 매치와 35개 마이크로 컨트롤 맵에서의 전투를 측정함. 비교 지표는 승률, 적 유닛 제거율, 응답 지연 시간, 그리고 게임당 모델 비용임.
3. 주요 발견
이 연구는 JEV-Star라는 새로운 AI 아키텍처를 제안하며, 빠른 반응성과 장기적 전략 수립 능력을 동시에 확보함.
(1) JEV-Star: 이중 처리 시스템의 핵심 정의 JEV-Star는 저비용의 즉각적 ‘전술’ 행동 선택(JEV)과 고비용의 ‘장기 전략’ 계획(GPT-6)을 분리하고 통합하는 이중 처리 시스템임. 이는 마치 인간의 ‘직관적 사고(JEV)’와 ‘숙고적 사고(GPT-6)’를 모방하는 구조임. GPT-6가 상위 수준의 목표를 설정하면, JEV는 그 목표에 따라 구체적인 게임 내 행동을 빠른 속도로 결정하고 실행함.
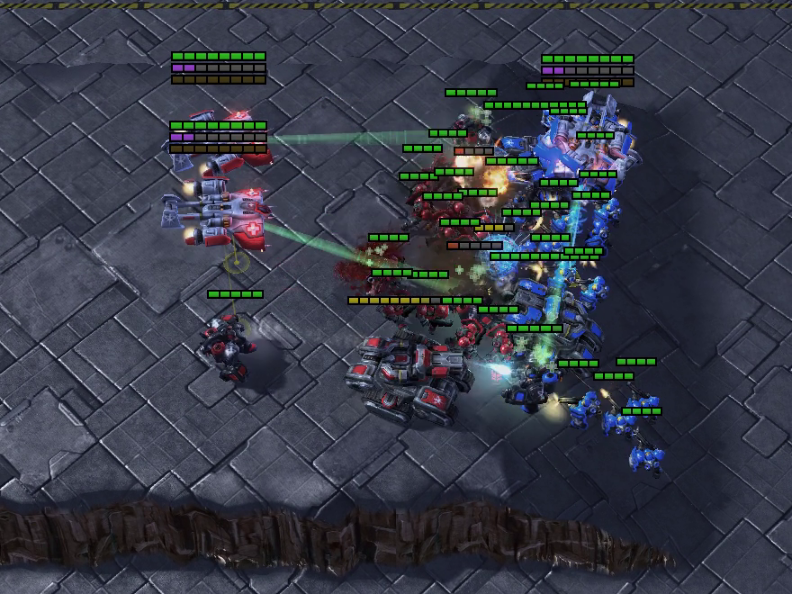
(2) JEV: 빠르고 저렴한 전술 행동 선택 모듈 JEV는 게임 내 현재 상태와 실행 가능한 행동 목록을 바탕으로 초당 1회 이하의 빈도로 다음 행동을 선택함. JEV의 선택은 게임 내 어댑터로 실행됨.
- 매크로 컨트롤: 자원, 일꾼, 건물, 병력 구성, 적 유닛 등 전반적인 게임 상태를 요약하여 유닛 생산, 건물 건설, 업그레이드, 확장, 공격, 후퇴 등 고수준 명령을 선택함.
- 마이크로 컨트롤: 개별 유닛의 체력, 위치, 사거리, 쿨다운, 에너지 등 전투 상황을 바탕으로 이동, 공격, 치료, 정지 등 유닛별 행동을 선택함.
(3) GPT-6: 비용은 높지만 장기적인 전략 계획 모듈 GPT-6는 더 넓은 관점에서 게임 상태를 분석하고 지속적인 전략적 가이드를 제공함. 이는 JEV가 단기적 이득에 매몰되지 않고 큰 그림을 따르도록 유도함.
- 매크로 계획: 경제 목표, 일꾼 및 기지 목표, 생산 우선순위, 자원 예약, 부대 자세(공격/방어) 등 장기적 목표를 설정함. 예를 들어, 확장을 위해 필요한 자원이 모일 때까지 다른 낮은 우선순위의 지출을 억제하는 ‘자원 예약’ 기능으로 장기 목표 달성을 위한 재정 관리를 가능하게 함.
- 마이크로 계획: 특정 맵에 대해 조건부 전술 및 역할(예: 어떤 유닛이 피해를 흡수하고, 어떤 대상을 우선 공격하며, 원거리 유닛은 언제 재배치할지)을 정의함. 이 계획은 맵당 한 번 생성되어 해당 맵의 모든 에피소드에 재사용됨.
(4) 압도적인 풀 게임 성능 향상
JEV-Star는 스타크래프트2 최고 난이도인 Lv7 AI를 상대로 4번의 풀 게임을 모두 승리하며 압도적인 성능을 보임. 이는 이전 LLM 기반 SC2 AI가 달성한 Lv5 (20게임 중 12승) 또는 Lv6 (8.33% 승률) 기록을 뛰어넘는 성과임. 반면 JEV 단독 제어기는 Lv2 AI를 상대로 20분 시간 제한 동안 단 한 번도 승리하지 못함. Lv8 AI(정보 우위 치트 사용)에 대한 스트레스 테스트에서는 패배하며, 여전히 강한 치트 상대를 넘어서는 경제-군사적 불균형이 존재함.
다음 표는 JEV-Star의 풀 게임 결과를 나타냄.
| 방법 | 난이도 | 시드 | 결과 | 게임 시간 | 실제 시간 |
|---|---|---|---|---|---|
| JEV-only | Lv2 | 1 | 시간제한 | 20:00 | 20:40 |
| JEV+GPT-6 | Lv5 | 1 | 승리 | 13:28 | 14:00 |
| JEV+GPT-6 | Lv6 | 1 | 승리 | 10:49 | 11:18 |
| JEV+GPT-6 | Lv7 | 1 | 승리 | 12:48 | 13:26 |
| JEV+GPT-6 | Lv7 | 2 | 승리 | 15:55 | 16:31 |
| JEV+GPT-6 | Lv8 | 1 | 패배 | 10:14 | 10:43 |
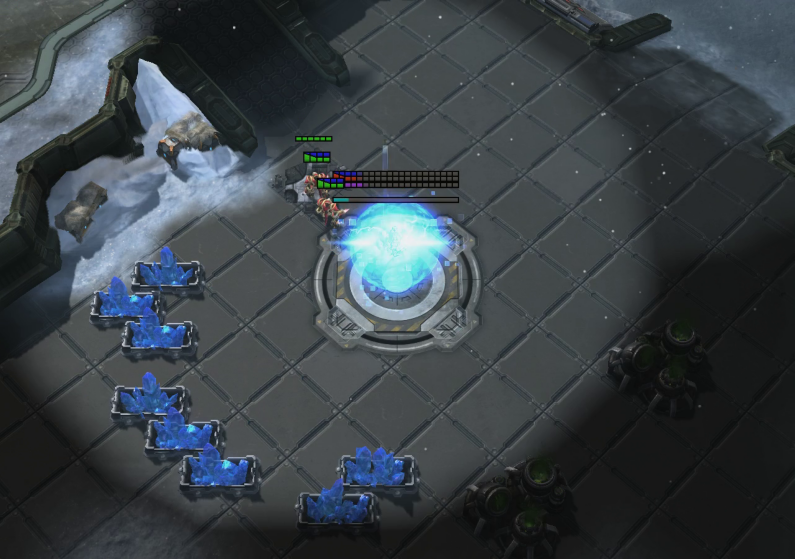
(5) 장기적 계획의 효과: 경제 발전과 군사 목표 유지 JEV 단독 제어기는 20분 동안 한 기지에 머물며 최대 광물 보유량이 335에 불과하여 확장을 위한 400 광물을 모으지 못함. 이는 JEV가 눈앞의 생산을 우선하기 때문임. 반면, JEV+GPT-6는 GPT-6의 ‘확장 목표’에 따라 자원을 예약하고, 광물 400을 달성한 후 2분 57초에 두 번째 넥서스 건설 명령을 내림.
다음 그림은 JEV-Star가 광물을 절약하여 넥서스 건설 자금을 마련하는 과정을 보여줌.
또한 JEV 단독 제어기는 짧은 시간 내 공격-후퇴를 5번 반복하며 전략적 일관성을 잃음. 반면 JEV+GPT-6는 GPT-6의 ‘지속적인 부대 자세(army posture)’ 계획(최소 30초의 약속 간격) 덕분에 이러한 반복적 전환이 전혀 발생하지 않음. 이는 계획 모듈이 행동 모듈에 전략적 ‘문맥’과 ‘제약’을 제공하여 단기적 변동에 흔들리지 않도록 함을 시사함.
다음 표는 JEV-Star와 JEV 단독 제어기의 경제 발전과 군사 목표 유지 능력을 비교함.
| 요소 | JEV-only (Lv2) | JEV+GPT-6 (Lv5) |
|---|---|---|
| 경제 확장 | 20분 내내 한 기지 유지, 넥서스 건설 광물 부족 | 2분 50초에 두 번째 기지, 최대 4~6개 기지 확장 |
| 군사 목표 유지 | 2초 내 공격-후퇴 5회 반복, 전략적 일관성 부족 | 2초 내 공격-후퇴 반복 없음, 일관된 목표 유지 |
(6) 비용 효율성과 응답 시간 JEV는 매크로 컨트롤에서 0.422초, 마이크로 컨트롤에서 0.500초의 빠른 중앙값 응답 시간을 보임. 반면 GPT-6 계획은 매크로에서 27.60초, 마이크로에서 37.17초로 훨씬 느림. 하지만 GPT-6 계획은 자주 호출되지 않아, 대부분의 즉각적 행동은 빠른 JEV가 처리함.
게임당 총 비용은 JEV-Star가 평균 3.71달러로 JEV 단독 제어기의 0.11달러보다 높음. 이 중 GPT-6가 3.56달러를 차지하여 전체 비용의 96%를 차지함. 이는 LLM 기반 계획의 비용이 높음을 의미하나, JEV의 저비용 행동 선택 덕분에 자주 상호작용하면서도 전반적인 게임 플레이 비용을 관리할 수 있음. 즉, 비싼 LLM을 꼭 필요한 장기 계획에만 사용하고, 저렴한 JEV를 반복적인 실행에 사용함으로써 비용 효율적인 하이브리드 시스템 구축이 가능함을 입증함.
4. 결론 및 시사점
(1) 이 연구는 즉각적 행동 선택(JEV)과 지속적 전략 계획(GPT-6)을 결합한 JEV-Star 시스템이 스타크래프트2 최고 난이도 AI를 제압하며, 기존 AI의 단기적 한계를 극복함을 입증함. 특히 자원 예약과 일관된 군사 목표 유지로 장기적 목표 달성이 가능함을 보여줌.
(2) 교육 현장 및 AI 설계에 주는 시사점은 명확함. 복잡한 문제를 해결하는 AI 에이전트 설계 시, 모든 결정을 하나의 대형 모델에 맡기는 대신, 빠르고 저렴한 하위 모듈에 일상적/반복적 결정을 맡기고, 느리지만 강력한 상위 모델에 핵심 전략과 장기 계획을 위임하는 ‘모듈화된 이중 처리 아키텍처’가 효과적임. 이는 비용 효율성과 성능을 동시에 잡는 설계 원칙을 제시함.
(3) 이 같은 이중 처리 방식은 학습 에이전트 설계에도 직접적 시사점을 제공함. 학습 과정에서 학습자가 즉각적인 피드백과 행동 수정(JEV 역할)을 받으면서도, 장기적인 학습 목표(GPT-6 역할)와 전략을 놓치지 않도록 AI가 지원하는 모델을 구상할 수 있음. 즉, AI는 학습자의 ‘전술적’ 고민을 덜어주면서 ‘전략적’ 성장을 돕는 조력자가 됨.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 이 논문에서 가장 주목할 지점은 AI가 '생각하는 방식'에 대한 중요한 질문을 던지고 그 해답을 제시한다는 점임. 우리는 흔히 LLM이 모든 것을 다 할 수 있을 것이라 기대하지만, 이 연구는 빠르고 반복적인 행동은 경량 모델에 맡기고, 느리지만 깊이 있는 전략적 사고는 LLM에 맡기는 ‘합리적 분업’을 제안함. 이는 LLM을 고비용 만능 해결사가 아닌, 시스템 전체의 효율성을 높이는 ‘전략적 사고 엔진’으로 활용하는 실용적 관점을 제시함. 이 분업 구조는 실제 교육 현장에서 교사가 모든 학습자의 개별 행동 하나하나에 관여하기보다, 장기적인 학습 목표와 큰 그림을 제시하고, 학습자가 일상적인 학습 과정에서 스스로 해결책을 찾도록 돕는 방식과도 닮아있음.
(2) 논문이 명시하지 않은 더 넓은 의미는 인간 인지 이론, 특히 다니엘 카너먼의 시스템 1(직관적 사고)과 시스템 2(숙고적 사고) 개념과의 강력한 연결 고리임. JEV는 시스템 1처럼 빠르고 자동화된 즉각적 행동을, GPT-6는 시스템 2처럼 느리지만 신중하고 의도적인 장기 계획을 담당함. 교육학적으로 볼 때, 이는 학습자의 메타인지 능력 개발과도 밀접함. AI가 학습자에게 “지금 당장 무엇을 할까?”(JEV)와 “나는 궁극적으로 무엇을 배우고 싶은가?”(GPT-6)를 동시에 고려하게 돕는 튜터링 시스템 설계의 기반이 될 수 있음. 즉각적인 문제 해결에 급급하여 장기적 학습 목표를 잊지 않도록 AI가 ‘인지적 스캐폴딩’을 제공하는 것임.
(3) 이 연구를 발전시킬 구체적 아이디어는 두 가지임.
- 첫째, GPT-6의 계획 빈도를 게임 상황과 불확실성에 따라
동적으로 조절하는 모델을 탐구하는 것임. 게임 초반이나 위기 상황에서는 계획 빈도를 높이고, 안정적인 국면에서는 낮춰 비용을 최적화할 수 있음. 이는 교육 현장에서 학습자의 현재 학습 상태와 난이도에 따라 AI의 전략적 개입 빈도를 조절하는 것과 유사함. - 둘째, GPT-6가 생성한 장기 계획을
인간 교사가 검토하고 수정할 수 있도록 하는 ‘인간 중심 계획 검증 인터페이스’를 개발하는 것임. AI가 제시하는 전략이 항상 최적인 것은 아니며, 인간의 전문성과 경험으로 보완될 때 비로소 더 강력한 하이브리드 지능이 탄생함. 이는 AI 기반 학습 시스템에서 교사의 역할을 재정립하는 중요한 출발점이 됨.
6. 추가 탐구 질문
(1) JEV-Star와 같은 하이브리드 AI 아키텍처는 스타크래프트2 외에 수업 설계나 학습 콘텐츠 개발 같은 실제 교육 현장의 복잡한 문제 해결에 어떻게 적용될 수 있는가?
(2) AI 에이전트가 GPT-6와 같은 LLM으로 장기 전략을 세울 때, 그 전략의 설명 가능성(explainability)을 높여 인간 교사나 학습자가 AI의 의도를 명확히 이해하고 협력할 방법은 무엇인가?
(3) 비용 효율적인 AI 설계를 위해 LLM의 활용 빈도를 줄이는 방식 외에, 소형 언어 모델(SLM)이나 도메인 특화 모델을 JEV의 상위 계획 모듈로 사용하는 것이 성능과 비용에 어떤 영향을 미치는가?
출처
- Ma, W., Zhao, L., Zeng, Y., & Zhao, J. (2026). JEV-Star: Fast, low-cost StarCraft II control with language-model planning. arXiv preprint arXiv:2609.27331.