707 / 707
LLM과 함께 글쓰기: 대필 아닌 교정 편집자로
LLM(거대 언어 모델)이 글쓰기에 도움을 주는 시대이다. 하지만 그 활용법을 두고 많은 논의가 있다. 이 글은 LLM을 대필 작가가 아닌 유능한 교정 편집자로 활용해야 한다는 주장을 펼친다.
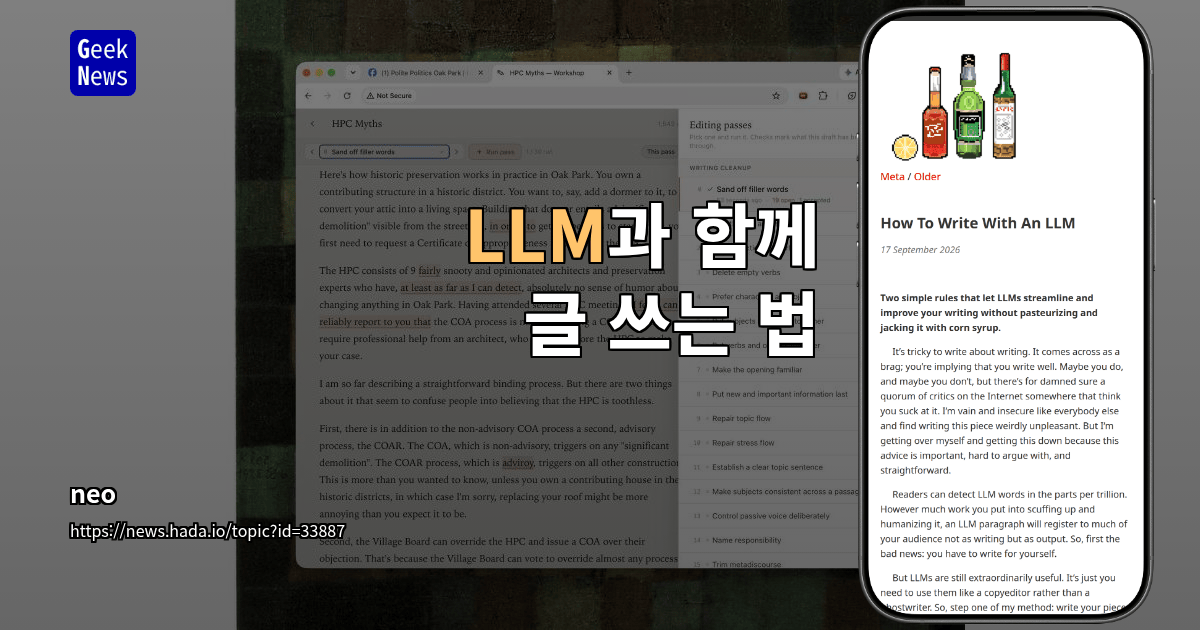
LLM 활용의 핵심 원칙
글쓰기에서 LLM을 대필 작가로 사용하면 글의 개성이 획일화될 위험이 있다. 모델이 작성한 문단은 독자에게 ‘생성된 출력물’로 인식되는 경향이 있다. 따라서 LLM은 글의 초안을 직접 작성한 뒤, 그 초안의 결함을 찾아내는 교정 편집 도구로 활용해야 한다. 이를 위한 두 가지 핵심 원칙이 있다.
LLM 활용의 두 가지 주요 원칙은 다음과 같다.
| 원칙 | 설명 | 이유 |
|---|---|---|
| 모델 제안 표현 사용 금지 | LLM이 제시하는 매력적인 문구나 표현을 단 한 단어도 쓰지 않는다. 기존 표현보다 낫다고 확신해도 예외를 두지 않는다. | 모델은 듣기 좋은 표현에 능숙하지만, 그 표현들은 글의 개성을 획일적인 가공품처럼 만들고 미묘하게 어색한 느낌을 준다. 모든 문장이 잡지 헤드라인처럼 변한다. |
| 칭찬과 격려 경계 | LLM이 글의 초안에 대해 칭찬이나 격려를 할 때 이를 경계한다. 명시적으로 격려를 금지하는 것이 좋다. | 칭찬은 초안의 나쁜 문단이나 일관성 없는 흐름까지도 고수하게 만든다. 이는 글쓴이가 원래라면 다시 생각하고 고쳤을 과정을 건너뛰게 하여 고유한 문체를 해친다. |
이 원칙들은 모델이 글에 깊이 스며들어 글쓴이의 고유한 표현을 흐리거나 독자의 관심을 잃게 만드는 것을 방지한다.
지루한 점검 작업 맡기기
LLM은 사람이 기계적으로 찾을 수 있으나 지루하고 소모적인 문장 문제를 탐지하는 데 탁월하다. 모델은 피로를 느끼지 않으므로 반복적인 점검에 매우 유용하다.
LLM에 맡길 수 있는 주요 점검 작업은 다음과 같다.
| 점검 항목 | 세부 내용 | 유의 사항 |
|---|---|---|
| 수동태 남용 | 글 전체의 수동태 표현 빈도를 확인한다. | 모델의 조언을 맹목적으로 따르면 수동태를 너무 적게 쓰는 문제가 발생할 수 있다. |
| 동사 명사화 | 동사가 명사 형태로 변형되어 동작이 잘 드러나지 않는 문장을 찾는다. | ~에 대한 검토가 이루어졌다를 ~을 검토했다로 고치는 작업이 해당한다. |
| 불필요한 수식어 | ‘매우’, ‘안타깝게도’, ‘정말’, ‘실제로’ 등 의미를 크게 더하지 않는 부사를 찾아낸다. | 글의 명료성과 간결성을 높인다. |
| 반복 표현 및 단어 | 문장이나 문단 내에서 불필요하게 반복되는 단어나 구절을 지적한다. | 글의 읽는 재미를 저해하는 요소를 제거한다. |
| 문단 재배치 | 문단들의 논리적 흐름이나 명료성을 개선하기 위한 재배치 제안을 한다. | 위치를 바꾸는 것만으로도 글의 이해도가 즉시 높아지는 경우가 있다. |
모델은 이처럼 기계적인 점검을 수행하고, 글쓴이는 직접 수정 작업을 한 뒤, 편집 맥락을 모르는 다른 모델에게 원문과 수정본을 비교하게 하여 객관적인 평가를 받을 수 있다.
개인화된 편집 시스템 구축
글쓰기 역량을 체계적으로 높이려면 편집 작업을 설계도에 따라 진행하는 것이 효과적이다. 이는 마치 프로그래밍에서 ‘C Interfaces And Implementations’ 같은 책이 체계적인 코딩 설계를 제공하는 것과 유사하다. ‘Style: Lessons In Clarity And Grace’라는 책은 문장 편집을 Java 코딩처럼 지루하지만 효과적인 작업으로 만들어 준다.
이러한 책들을 참고하여 편집 프롬프트 목록을 만들고, 글을 여러 차례 점검하는 과정을 거친다. 작업 순서는 다음과 같다.
- 모델에 문제 탐색 지시: 글에 어떤 문제가 있는지 LLM에게 찾아달라고 요청한다.
- 직접 수정: 모델이 지적한 문제에 해당하는 문장, 문단, 절을 글쓴이가 직접 다시 작성한다.
- 수정본 비교 평가: 편집 과정의 맥락을 모르는 LLM에 원문과 수정본을 제시하고, 어느 쪽이 더 나은지 비교 평가를 요청한다. 이때, 방금 수정했다는 사실을 아는 모델은 사용자가 수정본이 더 낫다는 답을 원한다는 점을 알아챌 수 있으므로 주의한다.
또한, 글쓰기 워크숍 도구를 직접 만들어 활용할 수 있다. 예를 들어, Python, HTMX, SQLite, Tailwind 등을 사용하여 Notion 스타일의 글 편집기와 편집 점검용 강조 표시 기능을 구현할 수 있다. 강조된 부분에 대해 Genius 스타일의 사이드바 해설을 제공하고, 여러 문서와 수정 이력을 추적하며, 주요 수정 사항을 표시하는 기능을 갖춘다. 여기에 편집 프롬프트 목록을 넣고 Codex, Claude, Antigravity CLI 같은 다양한 LLM을 통해 실행하면, 자신만의 작업 방식에 최적화된 도구를 만들 수 있다.
최종 판단은 필자의 몫
LLM을 활용하는 핵심은 모델이 단어를 대신 고르거나 초안을 과대평가하게 만들지 못하도록 막는 것이다. 대신 LLM에게는 가장 지루하고 반복적인 작업을 맡긴다. 이렇게 하면 글쓴이의 고유한 목소리를 유지하면서도 더 빠르고 덜 힘들게 글을 개선할 수 있다.
LLM의 모든 교정 조언을 따를 필요는 없다. 최종적인 단어 선택과 수정 판단은 오직 글쓴이의 몫이다. 이 글의 작성자 또한 GPT5에 자신의 글을 평가해달라고 부탁했을 때, 분량이 20% 길다는 조언을 받았지만, 이를 줄이지 않기로 결정했다. 이는 글쓰기에서 자기다움을 지키는 것의 중요성을 보여준다.
동물행동학·각인 이론의 시선으로 보면
LLM이 글쓰기 개성을 획일화하는 현상은 동물행동학의 ‘각인(Imprinting)’ 개념과 유사한 면이 있다. 각인은 특정 시기에 나타나는 학습으로, 일단 형성되면 잘 변하지 않고 해당 개체의 고유한 행동 패턴을 결정한다. 글쓴이의 고유한 문체와 목소리 역시 글쓰기 과정에서 각인된 결과물이다. LLM이 ‘듣기 좋은 표현’으로 글을 다듬으려 할 때, 이는 마치 초기 각인을 무시하고 외부의 보편적인 패턴을 강요하려는 시도와 같다. 그 결과는 개체의 고유성을 잃고 표준화된, 어딘가 인위적인 결과물로 나타난다.