549 / 707
LLM은 왜 유독 일본 문화에 집착하는가? 숨겨진 편향의 기원
1. 연구의 목적
(1) 대규모 언어 모델(LLM)의 문화적 지식과 역량에 한계가 있음. 기존에는 LLM이 서구 또는 영어 중심의 관점을 확대 재생산한다는 인식이 지배적이었음. 하지만 문화 관련 질문에 대한 LLM의 특정 지역 선호도를 명확히 밝힌 연구는 부족한 상황임.
(2) 이 연구는 포괄적인 문화 관련 개방형 질문(CROQ) 데이터셋을 개발하고, 이를 활용하여 LLM의 숨겨진 문화적, 지역적 편향을 평가하는 새로운 프레임워크를 제시함. 나아가 언어가 이러한 편향에 미치는 영향과, LLM 훈련의 어떤 단계에서 문화적 편향이 발현되는지를 규명하는 것을 목표로 함. 기존의 서구 편향 통념과 상반되게, LLM이 일본 문화를 두드러지게 선호하는 현상을 밝히는 데 집중함.
2. 연구의 방법
(1) 이 연구는 LLM의 문화적, 지역적 편향을 평가하기 위한 새로운 프레임워크를 개발함. 모델에게 특정 지역 정보가 명시되지 않은 개방형 문화 질문을 제시하고, 모델이 응답 시 질문과 관련된 특정 지역을 암묵적으로 선택하도록 유도함. 이후 LLM을 평가 모델로 활용하여 생성된 응답에서 지리적 참조를 추출하고, 이를 수동으로 검증하는 방식으로 진행됨.
(2) 주요 분석 대상과 조건은 다음과 같음.
- CROQ 데이터셋 구축: 11개 주요 문화 도메인과 66개 세부 주제에 걸쳐 총 31,680개의 개방형 문화 질문으로 구성됨. 질문은 24개 언어로 번역되어 폭넓은 언어적, 지역적 커버리지를 확보함. 질문 생성은 GPT-5.1을 활용한 반자동 방식과 수동 검토를 병행함.
- 모델 비교: 8개의 주요 LLM (gpt-4o-mini, gemini-2.5-flash, claude-3.5-haiku, llama-4-maverick, command-r-08-2024, magistral-small-2506, deepseek-v3.2-exp, qwen3-next-80b-a3b-instruct)을 평가에 활용함.
- 주요 측정 지표:
- 다양성(Diversity): 모델 출력이 참조한 고유 국가 또는 지역의 수.
- 엔트로피(Entropy): 참조된 지역 분포의 균등성. 점수가 높을수록 분포가 균형적임을 뜻함.
- 원시 빈도(Raw Counts): 특정 국가 또는 지역의 참조 빈도수.
- 훈련 단계별 편향 분석: LLM 훈련의 기저(Base) 모델, 지도형 미세 튜닝(SFT), 지시 튜닝(Instruction-Tuning) 단계별로 문화적 편향이 어떻게 변화하는지 비교 분석함. 이는 영어 질문에 한정하여 진행됨.
3. 주요 발견
이 연구는 LLM의 문화적 편향에 대한 기존의 통념을 뒤집는 중요한 발견을 제시함. 기존에는 서구 또는 영어 중심 편향이 지배적이라는 인식이 강했으나, 이 연구는 LLM이 특정 문화에 예상 밖의 강한 선호를 보이는 새로운 양상을 밝혀냄.
(1) 새로운 문화적 편향: 일본 문화에 대한 두드러진 집중 기존의 문화적 편향 연구가 주로 서구 및 영미권 관점의 지배력을 지적해왔던 것과 대조됨. 이 연구는 LLM이 특정 문화 관련 질문에 응답할 때, 자국 언어 참조를 제외하면 일본과 미국에 대한 명확하고 강한 선호도를 보임을 발견함. 특히, 평가에 사용된 8개 모델 중 6개 모델에서 일본이 가장 자주 참조되는 외부 국가로 나타났음. 이는 모델의 내재적 문화적 중요도 우선순위에 일본이 크게 자리 잡고 있음을 명백히 보여줌.

(2) 언어가 문화적 편향에 미치는 영향 언어는 LLM의 문화적 참조 행동에 결정적인 영향을 미침.
- 자국 언어 편향의 강력함: 모든 모델에서 입력 언어가 공식 언어인 국가에 대한 참조가 압도적으로 많음. GPT-4o-mini는 응답의 78%가 자국 언어 관련 국가를 참조했으며, Command-R도 43%에 달함. 이는 모델이 언어와 해당 언어의 주요 국가를 강력하게 연결 짓는 경향이 있음을 보여줌. 이 강력한 경향은 모델 훈련 데이터 내의 언어-국가 공동 발생 신호에서 비롯됨이 분명함.
- 저자원 언어의 제한된 다양성: CommonCrawl 데이터량이 적은 저자원 언어(예: 순다어, 아삼어, 암하라어, 하우사어)는 자국 참조 비율이 높고 출력 다양성이 현저히 낮게 나타남. 반면, 영어, 중국어, 스페인어와 같은 고자원 언어는 자국 참조 비율이 낮고 더 넓은 문화적 참조 다양성을 보임.
- 훈련 데이터량과 다양성의 상관관계: CommonCrawl 데이터 비중(사전 훈련 자원의 대리 지표)과 모델 출력 다양성 사이에 강력한 양의 상관관계(Spearman’s r = 0.843, p < 0.001)가 확인됨. 이는 훈련 데이터 볼륨이 문화적 프레이밍에 직접적인 영향을 미치며, 데이터가 적을수록 모델의 창의적이거나 다양한 응답 능력이 저하될 수 있음을 시사함.
(3) 훈련 단계별 문화적 편향의 발현 지점 문화적 편향은 모델의 사전 훈련(Pre-training) 단계보다 후처리 훈련(Post-training) 단계에서 주로 형성되고 증폭됨을 이 연구가 명확히 함.
- 기저 모델(Base Models)의 상대적 균형: 기저 모델은 상대적으로 더 균형 잡힌 지리적 커버리지를 보임. 미국이 두드러지지만, 일본, 인도, 중국, 여러 유럽 국가들도 상당한 빈도로 참조됨. 이는 사전 훈련만으로는 비교적 확산된 문화적 연관성을 생성함을 의미함. 엔트로피 점수가 기저 모델에서 일관되게 가장 높은 수준을 나타냄.
- 지도형 미세 튜닝(SFT) 단계에서의 편향 심화: 가장 중요한 발견은 기저 모델에서 SFT로의 전환 과정에서 지리적 편향이 가장 크게 증가한다는 점임. SFT 단계는 소수의 지배적인 국가(특히 미국과 일본)에 대한 참조 빈도를 급격히 증가시키고, 동시에 엔트로피는 현저히 감소시킴. 이는 SFT가 모델의 문화적 우선순위를 강력하게 강화함을 보여줌.
- 지시 튜닝(Instruction-Tuning)의 역할: SFT 이후의 지시 튜닝은 SFT 단계에서 발생한 극단적인 편향을 부분적으로 완화하는 경향을 보이지만, 기저 모델에서 관찰된 균형 잡힌 분포를 완전히 회복하지 못함. 오히려 SFT 단계에서 학습된 문화적 우선순위를 상당 부분 보존하는 역할을 함.
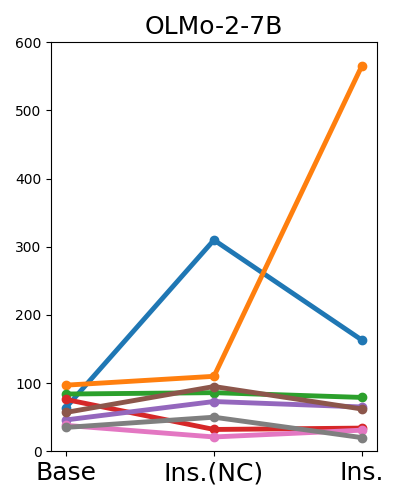
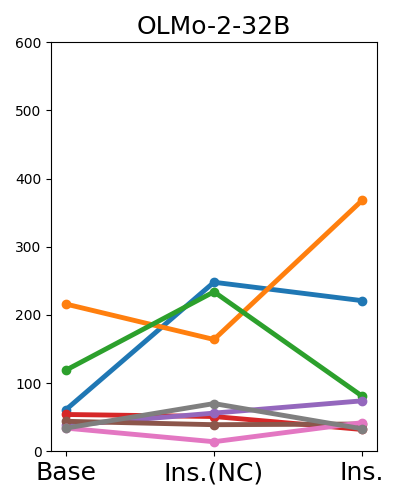

훈련 단계별 다양성과 엔트로피 변화는 다음 표로 요약할 수 있음.
| 모델 | 단계 | 다양성 | 엔트로피 |
|—|—|—|—|
| Llama-3.1-8B | Base | 109 | 0.78 |
| | Inst. | 174 | 0.66 |
| OLMo-3-7B | Base | 114 | 0.74 |
| | SFT | 145 | 0.66 |
| | Inst. | 124 | 0.64 |
| OLMo-2-7B | Base | 102 | 0.84 |
| | SFT | 151 | 0.63 |
| | Inst. | 158 | 0.64 |
이 표는 SFT 단계에서 다양성은 증가하지만 엔트로피는 감소하는 경향을 보여줌. 이는 참조하는 국가의 종류는 늘어나지만, 특정 국가에 대한 집중도는 오히려 높아짐을 뜻함.
4. 결론 및 시사점
(1) 이 연구는 LLM이 기존의 서구 중심 편향 외에 일본 문화에 대한 예상치 못한 강한 선호를 보임을 입증함. 이러한 문화적 편향은 모델의 사전 훈련 단계보다 지도형 미세 튜닝(SFT) 과정에서 주로 발생하고 증폭됨을 주장함. 또한, LLM의 출력 다양성은 훈련 데이터의 언어 자원 수준과 강력한 상관관계를 가짐이 밝혀짐.
(2) 교육 현장에 주는 시사점은 다음과 같음.
- 생성형 AI 콘텐츠의 비판적 검토 역량 강화: LLM이 생성하는 교육 콘텐츠나 학습 자료는 특정 문화(특히 일본, 미국)에 편중될 위험이 큼. 교사 및 학습자는 AI가 제공하는 문화 관련 정보가 전 세계적 다양성을 충분히 반영하는지 비판적으로 검토하는 역량을 길러야 함. 일방적인 정보 수용에 그치지 않고 AI의 문화적 편향을 인지하고 다각적인 관점을 스스로 찾아낼 수 있는 디지털 리터러시 교육의 확장이 필수적임.
(3) AI 설계 및 교육 현장 적용에 주는 시사점은 다음과 같음.
- 프롬프트 엔지니어링을 통한 문화적 다양성 유도: 교육용 LLM 활용 시, 교사들은 문화적 다양성을 명시적으로 요구하는 프롬프트를 설계하는 기술을 습득해야 함. 예를 들어, “다양한 문화권의 사례를 포함하여 설명해 줘” 또는 “특정 지역에 국한되지 않는 보편적인 관점에서 답해 줘”와 같이 구체적인 지시를 반드시 포함하는 프롬프트 전략이 필요함. 이는 모델이 특정 문화적 배경에만 의존하는 것을 방지하고, 더 포괄적인 학습 경험을 제공하는 데 기여함.
- SFT 데이터셋의 윤리적 큐레이션: LLM 개발자는 지도형 미세 튜닝(SFT) 데이터셋 구성 시 문화적 편향성을 엄격히 관리해야 함. 특정 지역의 콘텐츠가 과도하게 반영되지 않도록 다문화 데이터 수집 및 선별 과정에서 강화된 윤리적 검토를 수행함이 중요함. 궁극적으로, 교육용 LLM은 문화적 균형을 유지하고 모든 학습자에게 공정한 정보 접근 기회를 제공해야 함.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 이 논문에서 가장 주목할 지점은 기존의 LLM 편향 연구가 ‘서구 중심’이라는 단일 프레임에 갇혀 있었던 관행을 과감히 깨뜨리고, LLM이 특정 비서구 문화, 특히 일본 문화에 대해 예상치 못한 강력한 선호도를 보임을 밝혀냈다는 점에 있음. 이는 AI의 문화적 편향이 단순히 학습 데이터의 언어적·지리적 불균형에 더해 전 세계 웹 콘텐츠의 소비 패턴과 특정 문화 콘텐츠의 ‘소구력’ 같은 미묘한 사회문화적 요인에 의해 복합적으로 형성될 수 있다는 반직관적 통찰을 제시함. AI가 문화적 헤게모니를 어떻게 내면화하고 재현하는지에 대한 논의를 더 복잡하고 다층적인 수준으로 끌어올림이 이 연구의 핵심 기여임.
(2) 이 연구가 명시하지 않은 더 넓은 의미는 디지털 글로벌 문화 콘텐츠의 영향력과 AI 학습 사이의 구조적 연결고리를 보여준다는 점임. 일본 애니메이션, 만화, 게임, 대중음악 등은 전 세계적으로 강력한 팬덤을 형성하며 웹 콘텐츠의 상당 부분을 차지함. LLM이 이러한 방대한 웹 데이터를 학습하는 과정에서, 특정 문화 콘텐츠의 압도적인 양과 높은 인기가 모델의 ‘문화적 지식’을 왜곡할 수 있다는 의미임. 이는 인지과학적 관점에서 보면, AI가 문화적 지식을 ‘사실’로 습득하기보다 ‘빈도’와 ‘강도’에 기반한 유사성 학습으로 특정 문화를 선호하게 됨을 의미함. 교육 정책적 관점에서, 디지털 리터러시 교육은 AI의 정보 생산 원리뿐 아니라, 글로벌 웹 문화의 비대칭적 소비가 AI의 인식을 어떻게 형성하는지까지 포함해야 함.
(3) 이 연구를 발전시킬 구체적 아이디어는 다음과 같음.
- 문화 콘텐츠 유형별 상세 편향 분석: LLM의 일본 문화 편향이 애니메이션, 음식, 역사 등 특정 콘텐츠 유형에 국한되는지, 아니면 전반적인 문화 영역에 걸쳐 나타나는지를 세분화하여 분석함이 필요함. 특정 문화 콘텐츠의 글로벌 소비 데이터와 LLM의 내부 임베딩 공간을 비교하여, 어떤 문화적 요소가 편향을 유발하는 핵심 원인인지를 정량적으로 밝힘.
- 능동적 디바이어싱(Debiasing) 및 문화 증강 전략 개발: 지도형 미세 튜닝(SFT) 단계에서 특정 문화의 과도한 참조를 줄이거나, 소수 문화권의 고품질 데이터를 인공적으로 증강하는 기술적 방법론을 개발함. 예를 들어, 특정 문화적 개념에 대한 ‘지식 그래프(knowledge graph)’를 활용하여 모델이 균형 잡힌 문화적 관점을 형성하도록 유도하는 보상 모델을 설계하고, 그 효과를 검증함. 교육용 AI 개발 시 문화적 균형을 유지하는 실질적 가이드라인과 벤치마크를 함께 제시함이 중요함.
6. 추가 탐구 질문
(1) 이 연구에서 밝혀진 LLM의 일본 문화 편향이 단순히 영어 콘텐츠 내 일본 대중문화의 압도적인 영향력을 반영한 결과인가, 아니면 일본어 데이터셋 자체의 고유한 특성에서 비롯된 것인가? 언어별 콘텐츠 유형(예: 애니메이션, 음식, 비즈니스 등)을 세분화하여 분석하면 어떤 차이가 드러날까?
(2) 특정 문화권에 대한 LLM의 편향이 실제 사용자 경험에 미치는 영향은 무엇인가? 예를 들어, 비일본 문화권 사용자가 일본 문화에 편향된 AI 응답을 받았을 때 학습자의 문화 이해도, 학습 동기, 또는 AI에 대한 신뢰도에 어떤 변화가 나타나는가? 이는 다문화 교육 환경에서 LLM 활용의 효과성을 어떻게 재평가하게 할까?
(3) 모델의 ‘문화적 관점’을 다변화하기 위해, 특정 문화에 대한 과도한 참조를 줄이는 것 외에, 소수 문화권의 가치와 지식을 ‘능동적으로’ 학습시키는 방법은 무엇인가? 이러한 인위적인 개입이 역설적으로 새로운 형태의 문화적 편견이나 스테레오타입을 만들 위험은 없는가?
출처
- Fernandez de Landa, J., Perez-Almendros, C., & Camacho-Collados, J. (2026). Why are all LLMs Obsessed with Japanese Culture? On the Hidden Cultural and Regional Biases of LLMs. arXiv preprint arXiv:2604.21751.