764 / 764
가재코드 autoresearch, 웹 리서치와 데이터 실험을 섞어 판정까지 내리는 리서치 미션
가재코드(Gajae-Code, 명령어 gjc)에는 코드를 고치지 않는 워크플로가 하나 있다. 번들 스킬 autoresearch다. 웹 리서치와 데이터 실험을 한 미션 안에서 섞어 돌리고, 마지막에 구조화된 판정 하나를 남긴다. 산출물은 탐색 결과, 증거, 실행 기록, 판정이며 제품 코드는 만들지 않는다. 가재코드 전반(구독 플랜 로그인, 휴대폰 응답, 설치)은 앞서 이미 쓰는 구독으로 돌리는 코딩 에이전트, gajae-code 정리에서 다뤘다. 이 글은 autoresearch와, 그 데이터 실험을 받치는 Python REPL을 저장소 문서대로 정리한다. 2026년 10월 16일 기준 최신 릴리스는 10월 12일에 나온 v0.18.11이다.
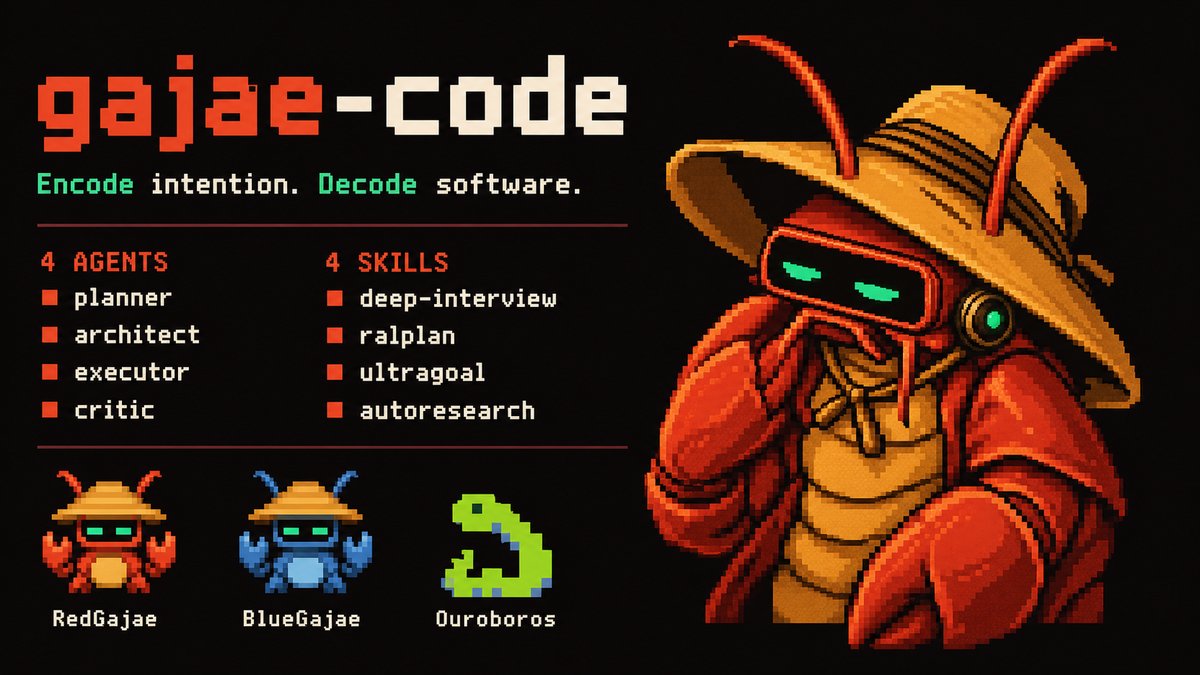
워크플로에서 autoresearch가 놓이는 자리
가재코드는 워크플로 표면을 일부러 작게 유지한다. 스킬 4개와 역할 에이전트 4개(executor, architect, planner, critic)가 전부다. README는 스킬의 흐름을 이렇게 그린다.
deep-interview -> ralplan -> ultragoal
               └─ 리서치가 계획을 뒷받침해야 할 때 선택적 autoresearch 미션
deep-interview는 모호한 요청을 구체적인 요구사항으로 바꾸고, ralplan은 코드 변경 전에 구현 계획을 세워 비평하며, ultragoal은 실행·수정·검증·증거까지 목표를 추적한다. autoresearch는 이 줄기 옆에 붙는 선택 미션이다. README는 “목표 지향 리서치 미션을 수행하고 구조화된 판정으로 마무리한다”고 설명한다. 스킬 문서에 따르면 폐기된 autoresearch 확장을 GJC 고유의 워크플로 스킬로 다시 만든 것이다.
설치는 README의 공식 설치 스크립트로 한다. Linux·macOS에서는 아래처럼 받아 실행하고, Windows는 같은 위치의 install.ps1을 PowerShell로 받아 실행한다. 주소의 v0.15.3은 설치 스크립트 파일의 판을 고정한 것이다. 이 스크립트는 --ref로 태그를 지정하지 않으면 stable 채널의 최신 릴리스를 받아 설치한다.
curl -fsSL https://raw.githubusercontent.com/Yeachan-Heo/gajae-code/v0.15.3/scripts/install.sh -o gjc-install.sh
sh gjc-install.sh
언제 쓰고 언제 쓰지 않나
스킬 문서가 꼽는 사용처는 범위가 정해진 리서치 미션, 그중에서도 결과물이 코드가 아니라 방어할 수 있는 판정인 경우다. “알아봐 줘”, “조사해 줘”, “벤치마크하고 결론 내 줘” 같은 요청이 여기에 해당한다.
- 결론을 내기 전에 웹이나 로컬 데이터, 또는 둘 다에서 증거가 필요한 질문. 문서는 “이 데이터셋에서 X가 성립하는가?”, “어느 접근이 벤치마크에서 가장 좋은가?”, “두 릴리스 사이에 무엇이 바뀌었는가?”를 예로 든다.
- 사용자가
autoresearch실행을 명시적으로 요청할 때. - 증거와 주의 사항이 붙은 구조화된 판정을 받아야 끝나는 목표.
반대로 다음 경우에는 쓰지 않는다.
- 곧바로 계획 단계가 이어질 평범한 사전 조사. 리서치 미션을 열지 말고
ralplan이나deep-interview로 보낸다. - 무엇이든 구현하는 일. autoresearch는 결과와 판정만 낼 뿐 코드는 만들지 않으며, 구현은 승인 게이트를 거치는 일반 경로로 간다.
read나search한 번이면 바로 풀리는 짧은 질문.
실행 명령
슬래시 명령으로는 목표를 직접 주거나 deep-interview 사양 파일을 넘긴다.
/skill:autoresearch "<research goal>"
/skill:autoresearch --spec .gjc/_session-{sessionid}/specs/deep-interview-<slug>.md
워크플로 뒤의 지속 상태는 런타임 명령 gjc autoresearch가 관리한다. 스킬 문서는 문법을 다시 찾느라 도구 호출을 쓰지 말고 아래 명령을 그대로 쓰라고 적어 두었다.
gjc autoresearch --spec <deep-interview-spec-path>
gjc autoresearch "<goal>"
gjc autoresearch
gjc autoresearch read --json
gjc autoresearch clear
| 명령 | 하는 일 |
|---|---|
intake --spec <path> 또는 --spec |
저장된 deep-interview 사양으로 접수한다. 질문은 하나도 하지 않는다. |
"<goal>" 또는 인자 없이 실행 |
콜드 접수. 리서치를 시작하기 전에 목표, 제약, 산출물을 확정해야 한다. |
read --json |
현재 미션 아티팩트와 추가 전용 원장의 스냅숏을 보여 준다. |
clear |
미션 아티팩트와 작업 세트를 정리하고 원장에 mission_cleared를 기록한다. 세션의 python REPL 커널은 건드리지 않는다. |
두 가지 접수 방식
두 방식 모두 같은 미션 아티팩트(objective, mode, deliverables, constraints, slug)를 쓴다.
스펙 접수(spec intake)는 gjc autoresearch intake --spec <path>(또는 --spec 플래그만)로 저장된 deep-interview 사양을 읽고, 확인 질문 없이 바로 미션을 시작한다. 사양에는 autoresearch-mode: web 같은 줄로 미션 모드를 명시해야 한다. 이 선언이 없거나 잘못되면 그 자리에서 실패한다. 읽은 사양 경로와 핸드오프 시각은 미션 아티팩트에 기록된다.
콜드 접수(cold intake)는 gjc autoresearch "<goal>"이나 인자 없는 gjc autoresearch로 시작한다. 이때는 리서치 도구를 하나라도 쓰기 전에 목표, 제약, 산출물부터 확정한다. 웹 검색, python 커널, 하네스 구축은 모두 그 뒤의 일이다. 확정이 끝나면 모드를 명시해 미션을 기록한다.
모드는 web, mixed, data 중 하나
모든 미션은 web, mixed, data 중 하나의 모드를 명시적으로 갖는다. 모드는 접수 때 정하고 미션 아티팩트에 저장한다. 작업 공간에 데이터 파일이 있다는 이유로 모드를 추론하지 않으며, 모드 선언 없이 데이터 파일만 있으면 기본값을 적용하지 않고 거부한다. 데이터 컨텍스트는 data와 mixed 모드에서만 불러오고, web 모드에는 데이터 컨텍스트를 붙이지 않는다.
모드가 정하는 것은 어떤 증거원이 있느냐이지 언제 쓰느냐가 아니다. 웹 리서치와 데이터·환경 실험은 따로 관문을 둔 트랙이 아니어서 한 미션 안에서 자유롭게 섞인다. 웹에서 찾은 내용이 실험의 동기가 되고, 실험 결과가 다음 웹 검색을 부른다. 두 증거는 같은 미션 원장과 같은 최종 판정에 함께 들어간다.
하네스를 세우고 실험을 반복한다
미션은 두 단계로 돈다. 첫 단계는 하네스 구축이다. 기존 벤치마크 명령을 쓰거나, 이 미션용으로 명시적으로 승인된 리서치 전용 하네스를 쓴다. 하네스는 세 가지를 지켜야 한다.
- 성공하면 0, 실패하면 0이 아닌 값으로 종료한다.
- 주 지표를
METRIC <name>=<value>한 줄로 출력하고, 보조 지표도 같은 형식의 줄로 덧붙인다. - 같은 작업을 결정적으로 돌린다. 실시간 네트워크와 시각 의존성이 없어야 하고, 해당하면 시드를 고정한다.
제품 소스, 매니페스트, 의존성, 벤치마크 바이너리는 고치지 않는다. 쓸 만한 벤치마크를 얻으려면 코드나 하네스를 바꿔야 하는 경우, 그 한계를 주의 사항으로 기록하고 변경은 승인 게이트를 거치는 일반 구현 경로로 넘긴다. 기존 명령은 직접 돌려서 0으로 끝나는지, METRIC 줄이 하나 이상 나오는지 확인해 검증한다. 출력에는 ASI key=value 형식의 학습 줄이 섞여도 된다.
둘째 단계는 반복이다. 기존 실험을 baseline·keep·discard 규율로 되풀이하고 모든 실행을 기록한다.
| 기록 | 조건 |
|---|---|
keep |
주 지표가 좋아졌다 |
discard |
주 지표가 나빠졌거나 그대로다 |
crash |
실행이 실패했다 |
checks_failed |
검증이 실패했다 |
보상 해킹이 의심되거나 무효인 실행에는 플래그를 달아 기준선과 최고 지표 계산에서 뺀다. 제품 코드를 바꾸지 않으므로 이 워크플로는 브랜치를 만들거나 커밋하거나 파일을 되돌리지 않는다.
다음 실험은 내부 프롬프트 조각 auto-iterate가 제안한다. 읽기 전용 실험 계획자로, 코드를 고치거나 하네스를 돌리거나 python 도구를 부르거나 실행을 기록하지 않는다. 다음 실험 하나만 JSON(phase, experiment, target, expected_direction, decision_rule, flag_runs, rationale, confidence)으로 낸다. 플래그 없는 첫 keep 실행이 기준선을 세우기 전까지 phase는 baseline이고, 그 뒤로는 iterate다. 벤치마크를 속이지 말 것, 실제 작업이 더 넓은데 합성 입력에 과적합하지 말 것, 정확성을 지킬 것이 규칙으로 붙어 있다. 맥락이 부족하면 추측하지 않고 하네스 기준선을 세우거나 다시 확인하는 실험만 낮은 신뢰도로 제안한다. 실행은 미션 에이전트가 bash autoresearch.sh, 지속 python 커널, 실행 원장으로 맡는다. 이 조각은 사용자에게 노출되지 않아 슬래시 명령으로 찾을 수 없다.
판정 영수증과 비평가
미션은 미션 단위의 구조화된 판정 하나로 끝난다. 판정 영수증에는 네 가지가 담긴다.
status: 고정된 열거값이 아니라 구조화된 데이터다. 결론 여부는status.disposition으로 나타낸다.evidence[]: 판정을 받치는 증거.caveats[]: 판정을 약하게 만드는 주의 사항.evaluator: 판정을 낸 주체의 신원.
판정은 기본적으로 미션 에이전트가 스스로 낸다. 선택적으로 비평가 패스를 돌리면 미션 에이전트와 다른 평가자 신원이 판정에 따로 기록된다(critic_receipt). 판정은 레인마다 칸을 채워야 하는 엄격한 체크리스트가 아니라 최선 노력(best-effort) 판정이다. 빠진 레인은 자동 실패가 아니라 주의 사항으로 드러난다. status.disposition: "inconclusive"는 명시적으로 결론을 미룬 판정으로, 미션을 끝난 것으로 닫지 않고 후속 작업을 위해 열어 둔다. 미션 아티팩트를 끝내는 판정은 status.disposition: "conclusive"뿐이다.
비평가 조각 auto-critic은 읽기 전용이다. 코드를 고치거나 파일을 쓰거나 .gjc/ 상태를 바꾸거나 실험을 돌리거나 실행을 기록하거나 워크플로를 띄우지 않는다. 미션 아티팩트, 추가 전용 원장(실행, 플래그 달린 실행, 이전 판정), 실행 기록을 받아 다음을 확인한다.
- 판정의
status가 기록된 증거로 뒷받침되는가. - 플래그로 제외한 실행과 판정에 반하는 데이터까지 포함해 주의 사항을 정직하게 적었는가.
- 엄격한 체크리스트가 아니라 최선 노력 판정인가.
- inconclusive 판정을 억지로 결론으로 몰지 않았는가.
응답은 아래 JSON 객체 하나다. evidence는 1~4개이고, evaluator는 미션 에이전트와 다른 신원이어야 한다. inconclusive 판정도 정당하며, 이때는 confidence를 low로 두고 미션을 열어 둔다. 미션 아티팩트나 원장, 실행 기록이 없거나 읽을 수 없으면 판정을 지어내지 않는다. 대신 inconclusive, 빈 evidence, 빠진 맥락을 적은 caveats, low 신뢰도를 돌려주고, 의미 있는 비평을 하려면 무엇이 필요한지 밝힌다.
{
  "status": {
    "disposition": "conclusive|inconclusive"
  },
  "evidence": [
    "Recorded evidence supporting the verdict."
  ],
  "caveats": [
    "Remaining uncertainty, flagged-run exclusions, or missing evidence."
  ],
  "evaluator": "A distinct critic identity — never the mission agent's identity.",
  "confidence": "high|medium|low"
}
판정이 나올 때까지 골 모드로 민다
autoresearch는 에이전트에게 GJC 골 모드로 미션을 끌고 가라고 요청한다. 인라인 목표가 걸려 있으면 자율 연속 루프가 구조화된 판정 영수증이 생길 때까지 접수, 리서치, 판정 순으로 에이전트를 계속 떠민다. 이것은 지시로만 이뤄지는 협조적 연동이지 autoresearch 런타임이 강제하는 경계가 아니다. 에이전트가 통합 goal 도구를 직접 부르며, gjc autoresearch 명령과 훅은 목표 상태를 바꾸지 않는다.
- 생성: 미션 아티팩트를 쓴 직후
goal({"op":"get"})으로 확인한다. 목표가 없거나complete·dropped로 끝난 목표만 있을 때goal({"op":"create","objective":"Drive the autoresearch mission '<mission objective>' to a persisted structured verdict receipt"})로 만든다. 접수 질문 중에는 목표가 없으므로 콜드 접수의 확인 질문은 영향을 받지 않는다. - 충돌:
active나paused상태의 목표가 이미 있으면 새로 만들지 않는다. 다른 목표를 교체·재개·완료·드롭하지 않는다. 같은 미션 목표일 때만 이어 가고, 아니면 골 모드 없이 미션을 진행한다. - 재개: 미션에 다시 들어올 때(
gjc autoresearch read --json)는 최신 판정과goal({"op":"get"})을 함께 본다. 판정이 없거나 inconclusive면 위 규칙대로 목표를 만들거나 재개한다. conclusive면 새 목표를 만들거나 재개하지 않는다. - 완료: 판정 영수증이 저장되면 해당 목표에
goal({"op":"complete"})를 정확히 한 번 부른다. inconclusive를 포함해 어떤 판정이든 이번 목표 추적은 완료로 친다. 판정 기록은 추가 전용이고 멱등이 아니므로, 응답을 받지 못했다고 같은 판정을 다시 내지 말고 원장과 영수증부터 읽는다. - 자동 정리:
status.disposition: "conclusive"일 때만, 목표를 완료한 직후gjc autoresearch clear를 실행한다. 이 정리는goal({"op":"drop"})을 부르지 않는다. inconclusive이거나 disposition이 없으면 정리를 건너뛰고 미션을 열어 둔다. - 드롭: 수동
gjc autoresearch clear, 다른 스킬로의 핸드오프, 사용자 취소 때 이 미션의 끝나지 않은 목표만 드롭한다. 다른 목표는 드롭하지 않는다.
이 전환들은 트랜잭션이 아니다. gjc autoresearch clear나 스킬 핸드오프가 목표를 대신 드롭해 주지 않으므로, 에이전트가 도구를 쓸 수 있을 때 먼저 직접 드롭해야 한다. 취소나 핸드오프 실패 뒤에는 다시 들어와 goal({"op":"get"})으로 확인하고 해당 미션의 목표만 정리한다. 그리고 골 모드는 구현 권한을 주지 않는다. 연속 루프로 제품 코드 변경을 시작해서는 안 된다.
미션을 끝내는 두 방법
판정 전이거나 inconclusive로 열려 있는 미션은 두 방법 중 하나로 끝낸다. 둘 다 한 단계다.
- 계획·명확화로 넘기기: 도구를 쓸 수 있는 턴이면 이 미션의 목표를 먼저 드롭하고
/skill:ralplan,/skill:deep-interview,/skill:ultragoal중 하나를 부른다. autoresearch는 접수, 리서치, 판정 어느 단계에서든 넘길 수 있다. 워크플로 상태 이전은 스킬 도구가 원자적으로 처리하지만 목표 상태까지 정리해 주지는 않는다.gjc state로 따로 준비할 필요는 없다. - 정리만 하기:
gjc autoresearch clear가 미션 아티팩트와 작업 세트를 치우고, 원장에mission_cleared를 남기고, 워크플로를 완료로 표시한다. 넘길 대상은 필요 없다.
conclusive 판정이 난 미션은 목표 추적을 마친 뒤 에이전트가 같은 정리 절차를 요청한다.
상태는 세션 안에 저장된다
미션 상태는 세션마다 .gjc/_session-{sessionid}/autoresearch/ 아래에 저장되고, gjc autoresearch를 여러 번 불러도 유지된다. 이곳에 미션 아티팩트, 추가 전용 JSONL 원장, 세션 범위 실행 기록, TUI 실행 표 대시보드가 들어간다. 전역 저장소 ~/.gjc/autoresearch에는 쓰지 않는다.
원장에는 mission_created, mode_set, run_logged, verdict_issued, critic_recorded, mission_cleared 이벤트가 쌓이고, 판정과 비평 영수증은 해당 이벤트에 구조화된 데이터로 실린다. 모든 기록은 gjc autoresearch로 남기고 .gjc/는 손으로 고치지 않는다. 명시적인 강제 옵션이 없으면 .gjc/ 경로에 write, edit, ast_edit를 쓰지 않는다. 중간에 끊기면 .gjc/_session-{sessionid}/autoresearch/의 파일을 직접 읽지 말고 gjc autoresearch read --json으로 이어 간다.
구현하지 않는다는 경계
autoresearch가 내놓는 것은 리서치 결과와 판정이다. 구현이 필요하면 계획, 승인 대기, 명시적으로 승인된 실행으로 이어지는 일반 경로를 따른다. 하네스에 코드 변경이 필요하면 주의 사항으로 남기고 넘기는 것, 브랜치·커밋·되돌리기를 하지 않는 것, 골 모드 루프로 코드 변경을 시작하지 않는 것이 모두 이 경계에서 나온다.
데이터 실험을 받치는 Python REPL
data·mixed 미션에서 실험을 돌리는 도구는 python이다. 세션 단위로 유지되는 REPL이라 변수, 임포트, 불러온 데이터가 호출 사이에 남는다. 활성 미션이 없어도 쓸 수 있고, 실행할 때마다 세션 JSONL 기록에 추가된다. 커널은 같은 도구의 action: "clear"로 지우며, 세션을 정리할 때도 함께 정리된다. gjc autoresearch clear는 이 커널을 건드리지 않는다.
README가 Python REPL 문서로 연결하는 docs/python-repl.md는 packages/coding-agent의 Python 실행 스택을 설명한다. 문서 제목은 “Eval Tool Python Backend”로 중심은 eval 도구의 Python 백엔드이고, python 도구의 커널도 같은 커널 관리 구조 안에서 소유자만 달리해 유지된다.
의존성 없는 커널
eval 도구는 하나 이상의 Python 셀을 오래 사는 python3 서브프로세스 안에서 실행하고, 이 프로세스와 stdin/stdout으로 NDJSON을 주고받는다. Jupyter도, 커널 게이트웨이도, 추가 pip 의존성도 없이 Python 3.8 이상 인터프리터만 있으면 된다. 래퍼(runner.py)가 예전에 IPython이 맡던 MIME 번들 디스패치를 다시 구현해서 PIL, pandas, plotly, matplotlib 그림 같은 리치 display() 출력이 그대로 나온다. 셀마다 언어(py 또는 js), 타임아웃(초 단위, 1~600, 기본 30), reset(실행 전 해당 언어 커널 초기화)을 정할 수 있고, 한 세션 안에서 호출은 겹치지 않는다.
커널 하나는 python -u <runner.py>로 띄운 서브프로세스 하나다. 시작할 때는 인터프리터가 실행되는지 확인하고, 걸러 낸 환경 변수와 작업 디렉터리로 러너를 띄운 뒤, os.chdir(cwd)와 환경 주입, sys.path에 작업 디렉터리 추가를 하는 초기화 요청을 보내고 prelude를 실행한다. 종료할 때는 {"type": "exit"}를 보내 기다리다가 시간 안에 끝나지 않으면 SIGTERM, 그다음 SIGKILL로 올린다.
커널 유지 방식과 소유자
python.kernelMode가 재사용 방식을 정한다. 기본값 session은 세션 파일과 작업 디렉터리를 키로(세션 파일이 없으면 작업 디렉터리만으로) 커널을 재사용하고, 세션별로 실행을 큐에 줄 세운다. 유휴 축출, 세션 상한, 하트비트가 없어서 커널은 리셋, 소유자 정리, 프로세스 종료 때까지 산다. 셀을 돌리기 전에 커널이 죽어 있으면 새로 띄우고, 취소가 아닌 이유로 셀이 실패하며 커널이 죽으면 커널을 바꾼 뒤 그 셀을 한 번 다시 돌린다. per-call은 요청마다 새 프로세스를 띄웠다가 끝나면 내리므로 호출 사이에 상태가 남지 않는다.
유지되는 커널은 소유자 ID로 묶인다. eval 도구는 세션 파일과 작업 디렉터리에서 나온 세션 소유 ID를 쓰고, python 도구는 python:<session-id>라는 별도 ID를 쓴다. 둘을 일부러 나눠서 eval을 정리할 때 Python REPL 커널이 덩달아 정리되는 일이 없게 했다. 소유자별 커널은 소유 도구의 정리 동작(python은 action: "clear"), 세션 정리, Ctrl-C 같은 시그널 종료 세 경우에 정리된다.
한 호출에 셀이 여러 개면 같은 커널에서 차례로 돈다. 중간 셀이 실패하면 앞 셀의 상태는 메모리에 남고, 어느 셀이 실패했는지 알려 주며, 뒤 셀은 실행하지 않는다.
매직 명령
러너는 파싱 전에 IPython 스타일 매직을 일반 Python 호출로 바꿔 쓴다. 지원하는 매직은 다음과 같고, 모르는 매직 이름은 셀 안에서 NameError: UsageError: ...를 낸다.
| 매직 | 동작 |
|---|---|
%pip <args> |
python -m pip <args>를 출력 스트리밍과 함께 실행한다. 새로 설치한 패키지는 sys.modules에서 빼 다음 import가 새 설치본을 읽게 한다. |
%cd <path> |
os.chdir(path)(~ 확장 포함), 상태 이벤트를 낸다. |
%pwd |
os.getcwd()를 돌려준다. |
%ls [path] |
sorted(os.listdir(path))를 돌려준다. |
%env [KEY[=VAL]] |
환경 변수를 나열하거나 읽거나 설정한다. |
%set_env KEY VALUE |
os.environ[KEY]를 설정한다. |
%time <expr> / %timeit <expr> |
식의 실행 시간을 재고 밀리초 단위 상태 이벤트를 낸다. |
%who / %whos |
사용자 네임스페이스의 이름을 나열한다. |
%reset |
사용자 전역 변수를 지우고 prelude를 다시 넣는다. |
%load <path> |
파일을 새 셀로 읽어 실행한다. |
%run <path> |
runpy.run_path로 실행하고 전역 변수를 합친다. |
%%bash / %%sh |
셀 본문을 bash/sh로 실행한다. |
%%capture [name] |
본문의 stdout/stderr를 name에 담아 실행한다. |
%%timeit |
셀 본문의 실행 시간을 잰다. |
%%writefile <path> |
본문을 파일로 쓴다. |
!cmd / var = !cmd |
서브프로세스 셸로 명령을 실행하고 .n·.s 도우미가 있는 SList 형태 결과를 돌려준다. |
var = %name args |
줄 매직과 !cmd에 대입 형태를 쓸 수 있다. |
환경 변수와 인터프리터 선택
러너를 띄우기 전에 환경 변수를 거른다. PATH, HOME, 로캘 변수, VIRTUAL_ENV, PYTHONPATH 같은 핵심 변수와 LC_, XDG_, GJC_로 시작하는 변수만 통과시키고, OpenAI·Anthropic·Gemini 등 흔한 API 키는 제거한다. 러너에는 출력이 바로 전달되도록 PYTHONUNBUFFERED=1과 PYTHONIOENCODING=utf-8이 추가로 들어간다.
인터프리터는 다음 순서로 고른다. 가상환경을 고르면 그 bin(또는 Scripts) 경로를 PATH 앞에 붙인다.
- 활성화됐거나 찾은 가상환경(
VIRTUAL_ENV, 그다음<cwd>/.venv,<cwd>/venv) - 관리형 가상환경
~/.gjc/python-env PATH의python또는python3
백엔드 노출은 eval.py·eval.js 설정(둘 다 기본 true)과 GJC_PY 환경 변수로 고른다. GJC_PY가 0이나 bash면 JavaScript만, 1이나 py면 Python만, mix나 both면 둘 다 쓴다. Python 사전 점검이 실패해도 eval.js가 켜져 있으면 JavaScript 셀은 쓸 수 있다. 다만 language: "py" 셀은 ToolError를 내며 JavaScript로 자동 전환되지 않는다.
타임아웃, 취소, 입력
타임아웃이나 중단이 오면 호스트가 러너의 프로세스 그룹에 SIGINT를 보내고, 러너는 사용자 코드 안에서 KeyboardInterrupt를 일으킨다. 결과에는 cancelled=true가 붙는다. 요청과 요청 사이에는 러너가 SIGINT를 무시하도록 해 두어서 엉뚱한 취소 신호가 커널을 내리지 않는다. SIGINT를 보내고 5초가 지나도 끝나지 않으면(C 코드에 갇힌 경우 등) 호스트가 exit 요청, SIGTERM, SIGKILL 순으로 커널을 내리고 셀을 kernel-killed로 표시한다. 다음 호출은 새 커널로 시작한다.
대화형 표준 입력은 지원하지 않는다. 러너가 input() 프롬프트를 전달하지 않으므로 input()을 부르는 코드는 취소될 때까지 멈춰 있다. 데이터는 코드로 넘겨야 한다.
출력
stdout·stderr는 일반 텍스트로, display·result는 MIME 번들로 받는다. 표시 우선순위는 text/markdown, text/plain, text/html(기본 마크다운으로 변환) 순이다. application/json, image/png·image/jpeg, 상태 이벤트(application/x-gjc-status)는 구조화된 출력으로 따로 잡는다. Matplotlib은 MPLBACKEND=Agg로 화면 밖에서 그리고, 셀이 끝날 때마다 열린 그림을 PNG로 저장해 image/png로 내보낸 뒤 닫는다. 출력은 아티팩트 저장소에 남을 수 있어서, 잘린 결과는 artifact://<id>로 전체를 되찾는다.
Python이 PATH에 없으면 Python 3.8 이상을 설치하거나 ~/.gjc/python-env에 가상환경을 두면 된다. gjc setup python --check가 실제로 잡힌 인터프리터를 알려 준다.
함께 볼 문서, 연구 계획 원장
저장소의 docs/research-plan-ledger.md는 autoresearch 런타임의 일부가 아니다. 리서치 비중이 큰 작업에서 계획을 실행 순서 체크리스트보다 강한 계약으로 만들자는 설계 문서이며, 이슈 #932에 대한 공개 스파이크다. 계획 항목마다 검증할 주장, 그 주변의 불확실성, 필요한 증거, 주장을 무너뜨릴 반례, 출처가 충돌할 때 검증자가 할 일을 적게 한다.
| 스키마 | 주요 필드 | 내용 |
|---|---|---|
ResearchPlanItem |
claim, confidence, unknowns, evidenceNeeded, counterexampleQueries, sourceConflictPolicy, dropCondition, verifierChecks |
검증을 통과하거나 실패할 수 있는 가장 작은 주장과, 그 주장을 다룰 계획 |
ResearchEvidenceEntry |
claim, source, confidence, verdict(support·contradict·uncertain), notes |
주장 하나에 대한 증거 항목 |
ResearchLedgerVerdict |
claim, finalVerdict(accepted·rejected·uncertain), survivingSources, rejectReason, unresolvedUnknowns |
증거를 모아 내린 주장별 최종 판정 |
원장은 주장 중심이다. 워커가 계획 항목의 주장에 증거 항목을 붙이면 검증자가 이를 최종 판정으로 정리한다. 채택된 주장은 최종 답변에 인용하고, 기각된 주장은 rejectReason과 함께 밝히며, 불확실한 주장은 빼거나 미해결로 표시한다. 순서는 플래너가 계획과 함께 ResearchPlanItem[]을 내고, 워커가 반례 검색을 포함해 항목마다 독립적으로 증거를 모으고, 검증자가 verifierChecks, sourceConflictPolicy, dropCondition으로 모순, 출처 품질, 낡은 정보, 남은 불확실성을 확인하는 식이다.
문서의 예는 “모델 X가 프로덕션과 비슷한 작업에서 지연 시간을 30% 줄인다”는 주장이다. 원장에 이를 받치는 벤치마크와 함께 긴 컨텍스트 작업에서 나온 믿을 만한 반례가 들어 있으면, 검증자는 그럴듯한 요약이 분위기만으로 살아남게 두지 않고 넓은 주장을 기각한다. 첫 구현 스파이크는 packages/coding-agent/src/research-plan/ledger.ts다. 세 스키마의 TypeScript 인터페이스와 검증기, 반례·출처 충돌·드롭 조건에 걸리면 그럴듯한 주장도 기각하는 결정적 검증 도우미를 제공하고, 회귀 테스트(packages/coding-agent/test/research-plan-ledger.test.ts)가 함께 있다. 문서는 앞으로 /skill:ralplan이 이 구조를 ralplan 산출물에 JSON 블록이나 사이드카 형태로 내보낼 수 있다고 적고 있다.
출처
- Yeachan-Heo/gajae-code, GitHub 저장소(MIT, 최신 릴리스 v0.18.11, 2026-10-12). https://github.com/Yeachan-Heo/gajae-code
- README(한국어판·영문판). https://github.com/Yeachan-Heo/gajae-code/blob/main/README.ko.md · https://github.com/Yeachan-Heo/gajae-code/blob/main/README.md
- autoresearch 스킬 문서
SKILL.md. https://github.com/Yeachan-Heo/gajae-code/blob/main/packages/coding-agent/src/defaults/gjc/skills/autoresearch/SKILL.md - autoresearch 내부 조각
auto-critic.md·auto-iterate.md. https://github.com/Yeachan-Heo/gajae-code/tree/main/packages/coding-agent/src/defaults/gjc/skills/autoresearch docs/python-repl.md. https://github.com/Yeachan-Heo/gajae-code/blob/main/docs/python-repl.mddocs/research-plan-ledger.md. https://github.com/Yeachan-Heo/gajae-code/blob/main/docs/research-plan-ledger.md