775 / 775
학생들은 AI 답변을 무엇으로 판단하는가? 비판적 AI 리터러시의 8가지 평가 렌즈
1. 연구의 목적
(1) 챗GPT 같은 생성형 AI가 학생들의 학업에 빠르게 들어오면서 비판적 AI 리터러시가 중요한 교육 목표로 떠올랐음. 그러나 이 개념은 범위가 넓고 막연해서, 학생이 AI와 일상적으로 주고받는 순간에 무엇을 어떻게 따져야 하는지 알려 주지 못함. AI의 답은 유창하고 그럴듯해도 부정확하거나, 빠진 내용이 있거나, 과제와 동떨어지거나, 학습자의 맥락에 맞지 않을 수 있음. 학생에게는 AI 제안을 언제, 왜, 어떻게 쓸지 판단하는 힘이 필요함.
(2) 연구진은 학생이 AI가 만든 내용을 실제로 어떻게 평가하는지 분석해 비판적 AI 리터러시를 이루는 구체적인 평가 기준을 찾고자 함. 연구 질문은 세 가지임. 학생은 학업 과제를 하며 생성형 AI를 어떻게 쓰는가, AI 제안을 받아들일지 고칠지 어떻게 결정하며 두 집단의 평가 수준은 다른가, 비판적으로 평가할 때 어떤 기준을 쓰는가. 최종 목표는 AI를 수동적으로 받아들이던 학습자가 맥락을 살피며 숙고하고 책임 있게 판단하도록 돕는 틀을 내놓는 것임.
2. 연구의 방법
(1) 혼합 연구 설계를 씀. 양적 자료로는 AI 제안을 수용한 집단과 수정한 집단의 정보 평가 점수와 만족도를 비교했고, 질적 자료로는 학생들이 결정을 내리며 적은 평가 근거와 기준을 분석함.
(2) 참여자는 미국 남부 두 대학의 학생 44명임. A대학 교수공학 대학원 강좌의 석사과정생 32명과 B대학 테크놀로지 관련 강좌를 듣는 여러 전공의 학부 예비 교사 12명으로 구성됨. 연구진은 구글 AI 스튜디오로 웹 기반 챗봇을 만들어 기말 프로젝트에 쓰게 함. 챗봇은 답을 건네는 기계보다 프로젝트를 함께 고민하는 상대에 가깝게 설계됨. 학생이 과제 유형을 고르면 그에 맞춰 짧게 나눈 제안을 내고, 답 끝에는 생각을 다듬거나 다시 보게 하는 후속 질문을 붙임. 핵심은 명시적인 평가 단계임. 학생은 제안을 받을 때마다 수용(Accept)과 수정(Adapt) 중 하나를 고르고, 그 이유와 평가 기준을 글로 남겨야 했음.
(3) 자료는 대화 기록 229턴(1인 평균 5.2턴, 중앙값 3턴, 범위 1~22턴)과 결정 근거 글임. 대화 44건 중 34건(77.3%)이 여러 차례 주고받은 대화였음. 정보 평가(IE) 점수는 Li 외(2025)가 개발·타당화한 척도로 측정했으며, 생성형 AI 응답의 관련성·신뢰성·논리적 타당성을 따져 보는 정도를 봄. 만족도는 상호작용 뒤 자기보고로 받음. 양적 자료는 독립표본 t검정으로, 질적 자료는 미리 정한 코딩틀 없이 귀납적 주제 분석으로 다룸.
3. 주요 발견
연구는 학생들이 AI를 활용한 7개 단계와 챗봇이 맡은 5가지 기능적 역할을 밝혔고, 무엇보다 학생들이 AI 응답을 평가할 때 쓴 8가지 평가 렌즈를 찾아냄.
(1) 학업 과제 수행의 7단계와 AI의 5가지 역할
학생들은 설명, 기획, 브레인스토밍, 초안 생성, 수정, 평가, 성찰의 7개 단계에서 챗봇을 썼음. 이 단계는 모두가 차례로 거치는 고정된 순서가 아님. 학생마다 필요한 지점에서만 골라 썼고, 여러 단계에 걸쳐 쓴 학생도 있고 일부 단계에만 쓴 학생도 있었음. 챗봇은 그 과정에서 튜터, 아이디어 생성자, 의사결정 지원자, 편집자, 평가자의 다섯 역할을 맡음. 단계가 언제 무엇을 하려고 AI를 불렀는지를 보여 준다면, 역할은 그 순간 AI에게 무엇을 기대했는지를 보여 줌.
| 단계 | AI의 역할 | 설명 | 학생 프롬프트 예시 |
|---|---|---|---|
| 설명 | 튜터 | 개념·내용·과제 요구사항을 이해하려고 설명을 구함 | “가장 흔한 수행 격차는 무엇이고, 훈련에서 어떻게 다뤄야 하는가?” |
| 기획 | 의사결정 지원자 | 과제를 완성할 전체 방향·구조·접근을 세움 | “세 개 모듈로 된 교수설계 계획을 만들고 있다…” |
| 브레인스토밍 | 아이디어 생성자 | 새 아이디어·가능성·예시·대안을 냄 | “내 수업에 쓸 활동을 제안해 줄 수 있는가?” |
| 초안 생성 | 아이디어 생성자·편집자 | 과제 결과물의 첫 내용이나 예비 버전을 만듦 | “학생들이 훈련 모듈에 얼마나 만족했는지 알아보는 설문을 만들어 달라.” |
| 수정 | 편집자 | 이미 있는 내용을 고치고 다듬고 재구성함 | “수업 활동을 개선하는 데 도움을 받고 싶다…” |
| 평가 | 평가자 | 아이디어나 결과물의 질·적절성·효과에 대한 피드백을 구함 | “블룸의 분류법을 반영한 이 목표가 좋은가?” |
| 성찰 | 의사결정 지원자·평가자 | AI 제안을 검토하고 내 작업에 넣을지, 넣는다면 어떻게, 왜 넣을지 따짐 | “AI 제안을 수정하기로 했다. 왜냐하면…” |
초안 생성이 곧 AI 결과물을 최종본으로 받아들였다는 뜻은 아니었음. 학생들은 생성된 내용을 출발점으로 삼아 다시 고치고 평가하고 맥락에 맞췄음. 사람의 판단이 가장 뚜렷하게 드러난 지점은 성찰 단계로, 학생들은 AI 출력을 받기만 하지 않고 그것이 자기 결정에 어떤 영향을 줘야 할지 따졌음.
(2) 수용이냐 수정이냐는 비판성의 지표가 아님
AI 제안을 수용한 학생들의 만족도는 평균 4.63점(SD 0.62)으로, 수정한 학생들의 4.14점(SD 0.76)보다 유의하게 높았음(t(42) = 2.17, p = .036, d = 0.68). 반면 정보 평가 점수는 수용 집단 1.44점(SD 1.03), 수정 집단 1.61점(SD 1.26)으로 의미 있는 차이가 없었음(t(42) = -0.46, p = .649, d = -0.14). AI 답을 고친 학생이 그대로 받아들인 학생보다 더 비판적으로 평가했다는 근거는 나오지 않은 셈임.
질적 분석도 같은 방향을 가리킴. 수용한 학생들은 “응답이 적절하고 도움이 됐다”, “개선할 부분과 생길 수 있는 상황을 보여 주고 해결책까지 줬다”처럼 쓸모와 적절성을 따진 결과로 수용을 설명함. 수정한 학생들은 쓸 만한 제안을 맥락에 맞게 다듬는 경우가 많았음. 한 학생은 관련성과 정확성이라는 원칙으로 응답이 프롬프트와 수업 내용에 얼마나 맞는지 평가했다고 적음. 연구진은 수용과 수정이 의사결정의 결과일 뿐, 그 결정이 얼마나 비판적이었는지를 직접 보여 주는 지표는 아니라고 정리함. 비판성을 드러낸 것은 결정의 종류보다 그 뒤에 놓인 추론이었음.
(3) 비판적 AI 리터러시를 위한 8가지 평가 렌즈
학생들의 대화 기록과 결정 근거를 분석하자, AI가 만든 제안의 쓸모와 적절성, 파장을 따질 때 반복해서 쓰인 렌즈 8가지가 드러남. 정확성, 완전성, 과제 정합성·관련성, 개인화, 실용성, 창의성, 편향·공정성, 윤리·책임임. 학생들의 평가는 사실이 맞는지 확인하는 데서 멈추지 않았음. 연구진은 이 렌즈를 인식론적·맥락적·실용·설계·윤리·사회적 기준의 네 영역으로 묶음.
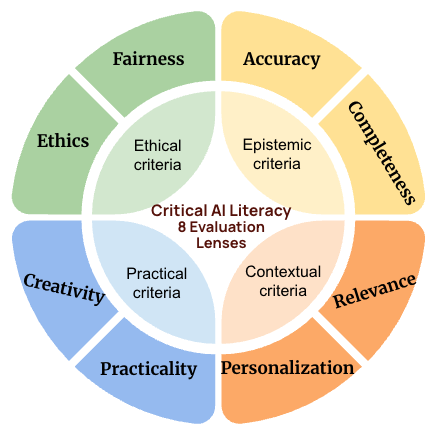
| 영역 | 평가 렌즈 | 평가 질문 | 학생 발화 예시 |
|---|---|---|---|
| 인식론적 | 정확성 | 정보가 정확하고 사실로 믿을 만한가? | “주제에 맞는 정확성을 봤다. 솔직히 모든 제안에 열려 있었고, 나중에 사실을 확인하고 실제로 실행할 방법을 따져 볼 생각이었다.” / “개념을 잘 설명했다.” |
| 인식론적 | 완전성 | 응답이 충분히 자세하고 구체적이며 포괄적인가? | “예시가 더 필요하다.” / “AI 제안은 자세했다.” / “정보를 충분히 주는지 확인하고 싶다.” |
| 맥락적 | 과제 정합성·관련성 | 응답이 과제와 관련 있고 그 목표·요구사항에 맞는가? | “내 과제와 이어지는 내용이 필요하다.” / “관련성을 확인하고 싶었다.” / “내 과제 목표와 맞지 않는다.” |
| 맥락적 | 개인화 | 응답이 의도한 청중·학습자·맥락에 맞는가? | “내 청중에 맞아야 한다.” / “목표 청중을 기준으로 AI 제안을 평가했다.” |
| 실용·설계 | 실용성 | 제안을 실제로 실행하고 적용할 수 있는가? | “현실적이지 않다.” / “이건 안 될 것이다.” / “활동이 적절하지 않았다.” |
| 실용·설계 | 창의성 | 응답이 독창적이고 다양하며 뻔하지 않은 아이디어를 주는가? | “뭔가 다른 것을 원한다.” / “너무 일반적이다.” |
| 윤리·사회 | 편향·공정성 | 응답이 치우치지 않고 공정하며 다양한 관점과 집단을 포용하는가? | “중립적인가, 편향됐는가?” / “가장 포용적인 경험을 위해 어떤 생각이 있는가?” / “이건 불리하게 작용할 수 있다… 포용적인 경험을 보장하려면…” |
| 윤리·사회 | 윤리·책임 | AI 응답을 쓰거나 적용하는 일이 윤리적이고 책임 있는가? | “내가 주제를 직접 조사하는 데 응답이 윤리적 선을 넘는지 살폈다.” / “주제의 윤리적·법적 측면을 다룬 단락이 들어 있어 정말 좋았다. 남용 가능성을 생각하면 꼭 필요하다.” |
렌즈 사이의 경계도 분명함. 편향·공정성은 AI 출력이 여러 집단을 어떻게 드러내고 누구에게 유리하거나 불리하게 작용하는지를 보고, 윤리·책임은 그 상황에서 AI를 쓰는 일 자체가 적절한지와 그 결과를 봄. 실용·설계 영역의 두 렌즈는 학생들이 AI를 정보원으로만 보지 않고 설계와 문제 해결의 협력자로 판단했음을 보여 줌. 학생들은 AI가 그럴듯한 답을 내는지보다 내 작업에 실제로 가치를 더하는지를 물었음.
4. 결론 및 시사점
(1) 비판적 AI 리터러시는 AI 답의 사실 여부를 가리는 일로 끝나지 않음. 연구진은 이를 인식론적 질, 맥락 적합성, 실행 가능성, 창의적 가치, 사회적 형평, 윤리적 책임을 함께 따지는 다차원적이고 상황 의존적인 판단으로 정의함. 정확하지만 과제와 무관한 답, 자세하지만 실행할 수 없는 답, 창의적이지만 청중에게 맞지 않는 답이 얼마든지 나올 수 있으므로, 이런 답을 알아보는 일도 비판적 평가에 속함.
(2) 연구진은 비판적 AI 리터러시의 목표가 AI를 무조건 의심하게 하는 것도, 쓸모 있어 보이면 받아들이게 하는 것도 아니라고 봄. 학습자가 AI의 기여를 맥락에 비추어 숙고하고 근거를 갖춰 판단하게 하는 것이 목표임. 생성형 AI가 아이디어와 설명, 피드백에 닿는 길을 넓혀 주어도 그것만으로 더 나은 결정이 나오지는 않음. 연구진은 비판적 AI 리터러시를 AI 사용 뒤에 덧붙이는 별도 기술로 보지 않고, AI의 도움을 받는 작업 안에서 사람의 주체성을 지키는 핵심 장치로 봄.
(3) 교실에 주는 시사점은 구체적임. AI를 비판적으로 쓰라거나 AI 답을 팩트체크하라는 막연한 지시 대신, 교사는 여덟 개 질문으로 학생의 판단을 이끌 수 있음. 정확한가? 충분히 완전한가? 내 과제와 관련 있는가? 내 청중과 맥락에 맞는가? 실행할 수 있는가? 창의적이거나 가치 있는 무언가를 더하는가? 공정하고 포용적인가? 그 사용이 윤리적이고 책임 있는가? 다만 연구진은 이 질문들을 모든 답에 똑같이 적용하는 체크리스트로 쓰지 말라고 강조함. 과제의 성격과 AI 생성물을 썼을 때의 파장에 따라 골라 쓰는 평가 관점의 목록으로 보아야 함.
(4) 연구에 쓴 챗봇의 설계도 하나의 시사점임. 이 챗봇은 답 끝에 후속 질문을 붙이고, 제안마다 수용·수정 선택과 이유 쓰기를 요구했음. 평가 단계를 도구 안에 넣었기에 학생의 추론이 기록으로 남았고, 연구진은 그 기록에서 평가 렌즈를 찾아낼 수 있었음. 수업에서 AI 도구를 고르거나 설계할 때도 학생이 판단 근거를 적게 하는 장치를 넣으면, 교사는 결과물과 함께 판단 과정까지 볼 수 있음.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 가장 주목할 지점은 수용과 수정이라는 행동이 비판적 사고의 질을 그대로 보여 주지 않는다는 발견임. 학교에서는 학생이 AI 답을 고쳤으면 비판적으로 썼고 그대로 냈으면 의존했다고 읽기 쉬움. 이 연구는 그 직관을 정면으로 의심함. 그대로 받아들인 결정도 따져 본 끝에 나온 것일 수 있고, 고친 결정도 대부분 AI 내용을 살린 채 청중과 과제에 맞춘 정도였음. 결과물만 채점해서는 비판성을 볼 수 없다는 뜻임. 다만 해석에는 조심할 부분이 있음. 보고된 표준편차와 표준오차로 역산하면 집단 크기는 수용 16명, 수정 28명 정도임. 이 규모로는 효과크기 d = -0.14 수준의 차이를 잡아낼 검정력이 낮으므로, 유의하지 않다는 결과를 두 집단의 비판성이 같다는 증거로 읽기는 어려움. 이 주장을 단단히 받치는 쪽은 통계보다 질적 근거임.
(2) 인접 분야와 이으면 이 연구의 평가 단계는 학습과학의 자기설명(self-explanation)과 닮았음. 수용·수정을 고르고 이유를 쓰는 순간 학생은 자기 판단을 말로 꺼내 점검하게 되므로, 메타인지 점검 활동에 가까움. 이 구조 안에서 AI는 정답을 건네는 기계라기보다 학습자가 자기 판단 기준을 드러내게 만드는 계기로 작동함. 연구진은 학습자를 정보를 해석하는 주체로 봐 온 비판적 문해력 전통(Freire 등)을 생성형 AI로 확장함. AI가 무엇을 말하는지와 함께, 그 답이 이 목적과 이 사람들, 이 조건에서 중요한지를 묻는 일임.
(3) 이 연구를 발전시킬 아이디어는 다음과 같음.
- 첫째, 학교급을 넓힌 연구가 필요함. 참여자는 교수공학 석사과정생과 예비 교사로, 교육 설계에 익숙한 집단임. 같은 렌즈가 초·중등 학생에게도 나타나는지, 어떤 렌즈가 먼저 자라고 어떤 렌즈가 늦게 나타나는지 확인해 볼 만함.
- 둘째, 렌즈별 수업 설계임. 한 학기 동안 과제마다 두세 개 렌즈를 골라 질문으로 제시하고, 학생의 결정 근거 글이 어떻게 달라지는지 추적하는 사례 연구를 해 볼 수 있음.
- 셋째, 비판성을 촉진하는 챗봇임. 답을 준 뒤 “이 제안을 당신의 청중에게 그대로 쓸 수 있을까요?”, “이 답 때문에 불리해질 수 있는 사람은 누구일까요?”처럼 렌즈에 맞춘 질문을 던지게 하고, 학생이 고른 렌즈가 과제 유형에 따라 어떻게 달라지는지 기록하는 방식임.
6. 추가 탐구 질문
(1) 학습자의 연령과 학습 수준, 과제의 복잡성에 따라 8가지 렌즈의 활용 빈도나 비중은 어떻게 달라지는가?
(2) 8가지 렌즈로 설계한 비판적 AI 리터러시 수업은 학생의 판단 근거와 AI 앞에서의 주체성에 장기적으로 어떤 변화를 가져오는가?
(3) AI 개발 과정에 8가지 렌즈의 기준을 반영해, AI가 스스로 답의 한계나 편향 가능성을 먼저 밝히도록 만들 수 있는가?
출처
- Lee, H., & Yu, W. (2026). What does it mean to use AI critically? Unpacking critical AI literacy through students’ evaluation of AI-generated content [Unpublished manuscript]. The University of Texas at San Antonio; The University of Alabama.