747 / 749
카르파티가 권한 AI 출력 형식 4단계, 쉬운 영어에서 설명 영상까지
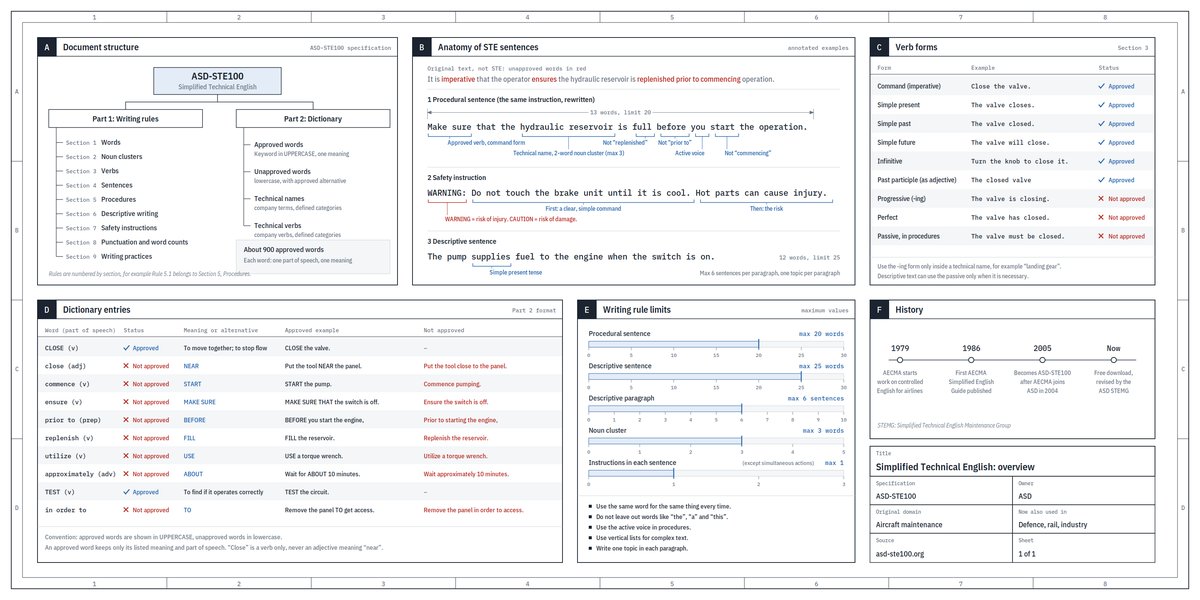
안드레이 카르파티(Andrej Karpathy)는 2026년 10월 2일 X에 “앞으로 언어 모델의 출력을 이해하는 데 훨씬 많은 시간을 쓰게 될 것”이라며 몇 가지 요령을 올렸다. 게시물은 10월 4일 기준 640만 회 조회됐다. 요령은 출력 형식 네 가지를 “But even better:”로 한 칸씩 올라가는 사다리처럼 엮은 것으로, ASD-STE100이라는 통제 영어로 쓰게 하는 데서 시작해 다이어그램, HTML 페이지, 맞춤 설명 영상으로 나아간다. 게시물에는 ASD-STE100을 한 장으로 요약한 이미지도 붙어 있었다.
이 글은 카르파티의 게시물과, 그 내용을 표준 원문과 연구 자료에 대조한 Max Nardit의 글(2026년 10월 4일)을 함께 정리한다. 따옴표로 옮긴 표현은 카르파티의 말이고, 형식별 장단점과 사실 확인은 Nardit의 분석이다.
카르파티가 제시한 네 단계
카르파티는 네 형식을 야심이 커지는 순서로 늘어놓았다. Nardit이 줄여 옮긴 카르파티의 말은 다음과 같다.
| 단계 | 카르파티의 말 |
|---|---|
| 글쓰기 | LLM에게 ASD-STE100으로 설명해 달라고 하면 효과가 있었다. ASD-STE100은 원래 항공우주 정비 문서용으로 개발된 통제 언어 사양이다. |
| 다이어그램·이미지 | 글 대신 다이어그램을 만들어 달라고 한다. 처리하고 파악하고 이해하기가 훨씬 쉬울 수 있다. |
| 웹 페이지 | “in HTML”로 출력해 달라고 하면 보기 좋은 인터랙티브 웹 페이지를 받는다. |
| 설명 영상 | 가장 기대하는 출력 형식은 어떤 주제든 그 자리에서 만드는 완전 맞춤형 설명 영상이다. |
글쓰기 단계에는 현실적인 단서가 붙는다. 사양이 꽤 엄격해서(“the spec is quite stringent”) 가끔은 “ASD-STE100에 80% 정도 맞춰” 달라고 한다는 것이다. 영상 단계에는 예시 프롬프트(“Create a 3b1b style video explainer on X. Use my ElevenLabs API key for audio narration”)를 들고, 대신 로컬 컴퓨터로 돌릴 만한 무료 대안을 모델에게 찾게 해도 된다고 덧붙였다.
핵심 주장은 요약에 있다. 모델이 일을 더 많이 맡을수록 “우리 일의 상당 부분이 추상화 단계를 올라가 감독과 이해로 옮겨 간다”는 것이다. 지능과 코드가 싸지면서 “예전에는 만들 이유가 없던 크고, 맞춤형이고, 쓰고 버리는 소프트웨어 산출물(웹 앱, 설명 영상 등)”을 요청할 수 있게 됐다. 카르파티는 2025년 연말 회고에서도 코드를 “한 번 쓰고 버리는” 것으로 부르며, 모델이 사람이 선호하는 형식으로 말해야 한다고 썼다.
Nardit은 이 방향에 동의하면서, 형식마다 무엇을 확인할 수 있는지를 따진다.
첫 번째 단계, ASD-STE100으로 쓰게 하기
ASD-STE100은 간이 기술 영어(Simplified Technical English, STE)라는 통제 언어다. 1979년 유럽 항공사들이 제2언어로 읽는 정비사도 잘못 읽을 수 없는 정비 문서를 항공기 제조사에 요구하면서 시작됐고, 첫 지침은 1986년에 나왔다. 유럽 항공우주·방위산업협회(ASD)가 관리하며, 2025년 1월 15일 발행된 Issue 9부터 사양(specification)이 아닌 국제 표준이 됐다.
표준은 두 부분으로 이뤄진다. 하나는 단어, 다중어 명사(multi-word nouns), 동사, 문장, 절차문과 설명문, 안전 지침, 구두점, 작성 관행을 다루는 아홉 섹션 53개 작성 규칙이다. 다른 하나는 대체로 한 단어에 뜻 하나, 품사 하나만 허용하는 승인 단어 약 900개와, 승인된 대체어를 단 비승인 단어 약 1,200개를 담은 사전이다. 정해진 범주의 기술 명사와 기술 동사도 쓸 수 있어서 STE가 900단어에 갇히지는 않는다. 흔히 인용되는 한도는 실제 규칙이다.
| 규칙 | 한도 |
|---|---|
| 절차 문장 | 최대 20단어 |
| 설명 문장 | 최대 25단어 |
| 단락 | 최대 6문장 |
| 다중어 명사 | 최대 3단어 |
| 지시 | 한 문장에 하나(동시에 일어나는 동작은 예외) |
| 태 | 능동태 |
| 구두점 | 세미콜론 금지 |
Nardit은 이 규칙이 LLM 문장을 피곤하게 만드는 습관을 정확히 걷어 낸다고 본다. “it is imperative that”이나 “prior to commencing” 같은 표현, 겹겹이 쌓인 절이 사라지고, 누가 무엇을 하는지 밝히는 쪽으로 기운다. 카르파티는 모델이 이 문체를 잘 알고 결과가 “훨씬 읽기 쉽다”고 말한다. 사람 독자에게 효과가 있다는 근거도 있다. 1996년 항공기 정비 기술자 175명을 대상으로 한 연구에서 간이 영어는 이해도를 높였고, 효과는 가장 어려운 작업 카드와 비원어민 독자에게서 가장 컸다.
가져다 쓰기 전에 알아 둘 점도 있다.
- 무료로 받을 수 있지만 재배포는 제한된다. 공식 다운로드 페이지에서 사본을 신청하며, 문서 저작권은 ASD에 있다.
- 표준의 FAQ는 STE가 “일반 글쓰기용이 아니다”라고 밝히면서도, 짧은 문장이나 능동태 같은 원칙은 다른 글에도 잘 통한다고 인정한다. 카르파티의 “80% 정도”가 바로 이 타협이다.
- 잘 쓰기가 어렵다. 표준 스스로 STE가 독자에게 최대한 이롭도록 만들어졌을 뿐 쓰기 쉽다는 뜻은 아니라고 말한다.
카르파티가 처음 꺼낸 아이디어도 아니다. 2026년 7월 GitHub와 Hacker News에 모델이 STE로 쓰게 만드는 스킬이 쏟아졌고, 그중 두 개는 별이 3,000개를 넘었다. 카르파티의 게시물은 이 방법을 훨씬 많은 사람에게 알렸다.
첨부 이미지가 틀린 곳
카르파티의 게시물에 붙은 요약 이미지에도 오류가 있었다. Nardit은 이 이미지를 2025년 1월 15일 발행된 Issue 9와, 필요한 곳은 Issue 8과 패널별로 대조했다. 맞는 부분이 많았다. 수치 한도(20, 25, 6, 3, 문장당 지시 하나), 승인된 동사 형태 여섯 가지, 2부 9섹션 구조, 승인 단어를 대문자로 쓰는 관례, 단어 수를 표시한 예문이 모두 정확했고, 사전 항목 10줄 가운데 7줄도 단어와 승인 여부가 맞았다. 틀린 곳은 다음과 같다.
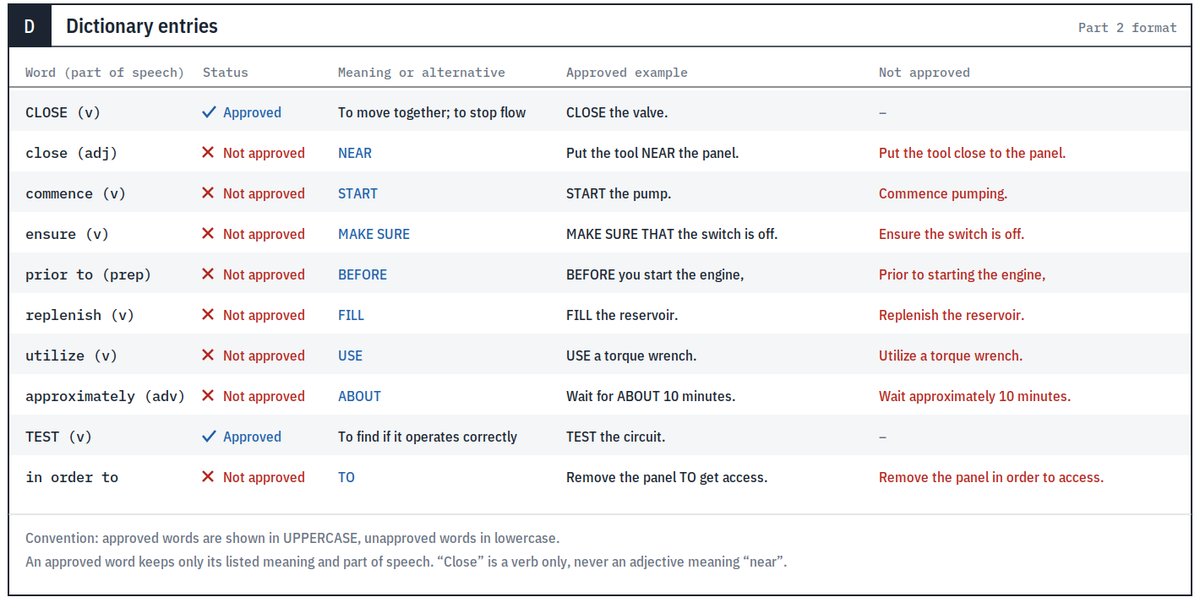
| 항목 | 요약 이미지 | 표준(Issue 9) | 문제 |
|---|---|---|---|
| approximately | 비승인 부사, 대체어 ABOUT(“Wait for ABOUT 10 minutes”) | APPROXIMATELY는 ‘거의 맞거나 정확한’이라는 뜻의 승인 부사. ABOUT은 ‘~에 관하여’라는 뜻의 전치사로만 승인 | 표준은 “Drain about 2 liters of fuel from the tank”를 쓰지 말아야 할 예로 든다. 이미지는 표준이 경고하는 오류를 가르친다. |
| TEST | 승인 동사, 정의는 “To find if it operates correctly” | 명사로만 승인. 그 정의는 표준에서 찾을 수 없음 | 표준의 예는 “DO A FUNCTIONAL TEST OF THE SOFTWARE”이고, “Functionally test the software”는 피할 표현이다. |
| in order to | 비승인, 대체어 TO | Issue 9와 Issue 8 사전 모두 해당 항목 없음 | TO로 줄이라는 조언은 표준 취지에 맞지만, 권고를 사전 항목처럼 제시했다. |
| 수동태 | 설명문에서 “필요할 때만” 허용 | 설명문에서 “행위자를 모를 때만” 허용 | ‘필요할 때’는 판단이고 ‘행위자를 모를 때’는 확인할 수 있는 기준이다. |
이 밖에도 구조 패널은 기술 명칭과 기술 동사를 사전 내용으로 넣었지만, FAQ는 사전에 이것들이 없고 작성 규칙에서 정의하는 범주라고 분명히 밝힌다. 용어도 Issue 9 이전 판인 Issue 8과 맞는다. ‘noun clusters’(현재는 multi-word nouns), ‘technical name’(현재는 technical noun), 제목란의 ‘Specification’(현재는 표준)이 그렇고, 연혁은 2025년 변화 직전에서 멈춘다.
게시물은 이미지를 누가 어떻게 만들었는지 밝히지 않는다. 출처가 무엇이든 결과는 같다. 쓸모 있는 요약과 틀린 사전 조언이 똑같이 권위 있어 보이는 레이아웃에 나란히 놓였다. 이 이미지는 벌써 근거로 쓰이고 있다. 게시물이 올라온 날 만들어진 한 저장소는 “Karpathy’s sheet”에서 한도를 가져왔다(공교롭게도 맞는 부분이다). 게시물보다 앞선 7월에 나온 다른 STE 스킬에는 승인 단어를 금지한 사전 행 12개를 지적한 이슈가 열려 있고, approximately도 그중 하나다. 기계가 만든 STE 단어표가 각자 같은 방식으로 틀린다는 뜻이다. 독자들도 일부를 잡아냈다. 게시물이 올라오고 약 20시간 뒤 한 답글이 ChatGPT 답변을 붙여 approximately 행을 지적했고, GitHub의 한 참고 파일도 같은 오류와 옛 용어를 기록했다. TEST 행, in order to 행, 수동태 문구를 지적한 사람은 Nardit이 찾아본 범위에서는 없었다.
표준 관리자들은 이런 일을 예상했다. 2026년 6월 STE와 AI에 관한 백서를 냈고, 다운로드 페이지는 그 내용을 두 문장으로 요약한다. “AI가 생성한 텍스트는 표준의 규칙과 어휘를 제대로 적용하지 않았을 때조차 명확하고 권위 있으며 STE에 부합해 보일 수 있다. 그럴듯함을 검증된 준수와 혼동해서는 안 된다.”
모델은 ASD-STE100을 정말 따르나
느슨하게 따르며, 실제보다 잘 따른다고 믿는 경향이 있다. 이를 가까이 들여다본 한 기술 문서 작성자는 모델의 결과물을 “STE가 아니라 STE 맛이 나는 영어”라고 부른다. 최신 사전과 대조하지 않으면 모델은 문체를 흉내 내면서 어휘 규칙을 어긴다. 카르파티의 게시물 답글에서 한 사람은 최신 모델 세 개가 요청을 “그냥 무시한다”고 했고, 다른 이들은 STE 답변과 일반 답변의 차이를 거의 느끼지 못했다. 7월 Hacker News에서도 준수 수준은 금세 흐트러지고 린터나 커밋 훅만이 이를 붙잡아 둔다는 의견이 거듭 나왔다.
측정 자료는 빈약하다. Lucian Ghinda가 코드 설명을 두고 돌린 소규모 비공식 테스트에서, Claude는 느슨한 “simple technical English” 요청에서 기준 답변보다 채점 대상 사실을 8.5% 적게, 엄격한 ASD-STE100 요청에서 46.8% 적게 언급했다. Codex에서는 각각 43.3%, 40.0%가 줄었다. 코드 샘플 네 개, 세션 두 번짜리 실험이라 순위가 아니라 단순화가 사실을 떨어뜨릴 수 있다는 경고로 읽어야 한다. 제약 준수(constraint following)를 다룬 2026년 사전 공개 논문 두 편도 모델이 자기 준수 수준을 과대평가하고, 규칙을 되뇌면서 그 규칙을 어길 수 있다고 보고했다.
Nardit의 실무 결론은 이렇다. 프롬프트 속 문체 규칙은 요청이지 보장이 아니다. STE가 정말 필요하면 모델 바깥에서 확인한다. 산문 린터 Vale에 지키게 할 규칙을 직접 정해 넣으면 “80%”라는 모호한 기준이 스스로 정한 규칙 목록으로 바뀐다. 다만 린터는 설정한 규칙만 검사할 뿐, STE 전체 준수나 내용의 참거짓을 보증하지 않는다.
다이어그램, HTML, 설명 영상
나머지 세 단계의 이점과 위험을 Nardit의 분석에 따라 묶으면 다음과 같다.
| 형식 | 이점 | 위험 | 쓰는 법 |
|---|---|---|---|
| 다이어그램 | 위치가 색인 역할을 해 같은 정보를 글보다 적은 노력으로 쓴다. 구조가 드러난다. | SVG·Mermaid 등 생성 벤치마크에서 아직 오류가 많다. 빠진 화살표가 의존 관계가 없다고 조용히 주장한다. 단순화하며 조건을 다는 말이 빠진다. | Mermaid·Graphviz처럼 읽고 비교할 수 있는 텍스트 형식으로 받고, 렌더링 결과를 본 뒤, 그린 관계를 모두 문장으로 나열하게 해 읽는다. |
| HTML | 슬라이더, 접는 섹션, 작은 시뮬레이션으로 가정을 바꿔 보며 결과를 확인한다. | 페이지가 검증하는 것은 페이지 속 모델이지 실제 시스템이 아니다. 답변보다 토큰과 시간이 더 든다. 잘 다듬어진 채로 틀릴 수 있다. | 가정을 화면에 드러낸 독립 실행 파일로 받고, 실제 시스템은 따로 테스트한다. |
| 설명 영상 | 텍스트 설명이 감춘 추론의 결함이 드러난다. | 대본이나 챕터 없이는 훑어보기 어렵다. 호스팅 내레이션 서비스로 개인 자료가 넘어간다. 애니메이션 위에 얹힌 틀린 주장은 글보다 잡아내기 어렵다. | 대본을 텍스트로 보관해 보기 전에 한 번 읽는다. 개인 자료는 호스팅 내레이션에 넣지 않는다. 대본, 자막, 원본 프로젝트를 남겨 주장을 검색할 수 있게 한다. |
다이어그램부터 보자. Larkin과 Simon은 1987년 논문 제목에서 이미 답을 냈다. “Why a Diagram is (Sometimes) Worth Ten Thousand Words.” 같은 정보를 담은 다이어그램은 위치가 독자 머릿속의 색인 작업을 대신해 주므로 글보다 훨씬 적은 노력으로 쓸 수 있다. Cromley와 Chen의 2025년 메타 분석은 멀티미디어 학습 연구 181편에서 전체 효과 크기 약 0.37을 얻었는데, 설계 원리와 결과 지표에 따라 편차가 컸다. 텍스트와 다이어그램을 함께 쓴 결과는 비교적 일관됐고 애니메이션은 훨씬 덜 일관됐다. 모델에 해당하는 주의점도 있다. 생성된 다이어그램은 아직 다이어그램으로서 믿기 어렵다. 단순화하면서 “if”, “unless”, “not yet verified” 같은 말이 빠지면 더 명확해진 문장이 더 센 주장이 되는데, 한 답글의 지적처럼 다이어그램에서는 빠진 화살표가 의존 관계가 없다고 조용히 주장한다. 반대로 화살표 하나가 거꾸로 그려진 덕분에 글이 감춘 진짜 오류를 잡은 사례도 나왔다. 다이어그램은 틀린 구조까지 포함해 구조를 드러내고, 빠진 것은 보이지 않게 만든다.
HTML은 브렛 빅터(Bret Victor)가 2011년 「Explorable Explanations」에 적은 목표와 닿아 있다. “반응형 문서는 독자가 저자의 가정과 분석을 직접 바꿔 보며 결과를 확인하게 한다.” 산문에는 없고 HTML 답변에는 있는 것이 이것이다. 답글에서 가장 호응이 컸던 단계도 HTML이었다. 여러 사람이 각자 같은 변형을 제안했는데, 답을 보여 주는 페이지가 아니라 가정 하나를 바꿔 무엇이 깨지는지 보는 페이지를 요청하라는 것이다. 그러면 설명의 가정을 들여다볼 수 있다. 다만 실제 시스템을 검증한 것은 아니다. 모델이 캐시 버그를 인터랙티브 페이지로 설명했다면 그 토글은 페이지 속 버그 모델을 검증할 뿐이고, 진단을 확인하려면 실제 코드와 입력으로 재현해야 한다.
설명 영상은 카르파티가 가장 기대하는 단계이자 근거가 가장 빈약한 단계다. “3b1b 스타일”을 내는 한 가지 방법은 그랜트 샌더슨(Grant Sanderson)이 3Blue1Brown용으로 만든 애니메이션 엔진 Manim(MIT 라이선스, 별 약 9.45만 개)이나, 문서가 더 잘 갖춰진 커뮤니티 포크 ManimCE를 쓰는 것이다. 둘은 설치 방법이 달라 어느 쪽인지 지정해야 한다. 모델이 Manim 코드를 쓰고, 그 코드가 애니메이션을 렌더링하고, 음성 합성 서비스가 내레이션을 붙인다. 답글에서는 하루 만에 확률 미적분, 결제가 작동하는 원리 같은 주제로 실제 영상이 나왔고, 그중 하나는 API 키 없이 로컬 도구만으로 만들었다. 연구 근거도 있다. TheoremExplainAgent(ACL 2025)는 정리 240개로 구성한 벤치마크에서 영상이 텍스트 설명이 감춘 모델 추론의 결함을 드러낸다는 결과를 얻었다. 애니메이션은 다음에 무엇이 일어나는지 확정하게 만들기 때문이다. 다만 시청자의 학습이 나아지는지는 검증하지 않았다.
영상에는 실무 주의점이 셋 있다. 카르파티의 예시 프롬프트에 나오는 ElevenLabs는 기본 설정에서 보낸 텍스트를 기록하고, 이를 끄는 기능은 엔터프라이즈 요금제에 있다. 개인 자료는 호스팅 내레이션에 넣지 말거나 로컬 방식을 쓴다. API 키는 프롬프트가 아니라 도구의 자격 증명 설정에 넣는다. 그리고 영상은 대본이나 챕터 없이는 훑어보기 어렵다. edX 영상 862편의 시청 세션 690만 건을 분석한 연구에서 시청 시간 중앙값은 약 6분을 넘지 않았다. 초기 답글 하나가 위험을 한 문장으로 요약했다. “3b1b 애니메이션 위에 내레이션된 틀린 주장은 틀린 문장보다 훨씬 잡아내기 어렵다.”
읽기 쉬운 출력과 검증하기 쉬운 출력
읽기 쉬운 출력이 저절로 검증하기 쉬운 출력이 되지는 않는다. 화살표 사례나 정리 설명 영상처럼 명확한 형식이 오류를 드러내기도 하지만, 근거 없는 주장을 받아들이기 쉽게 만들기도 한다.
뒤쪽 효과를 다룬 연구들이 있다. 2024년 연구(Si et al., NAACL)에서 LLM의 설명을 보며 주장을 사실 확인한 크라우드워커 약 80명은 설명이 맞을 때 87%를 맞혔지만, 설명이 틀렸을 때는 35%만 맞혔다. 같은 사례를 아무 근거 없이 판단했을 때의 49%보다 낮다. CHI 2021 연구는 설명이 AI 조언의 옳고 그름과 상관없이 사람들의 수용도를 높인다는 것을 발견했다. 텍스트 단순화 연구(Devaraj et al., ACL 2022)는 단순화한 글에 사실 오류가 흔하며, 읽기 쉽지만 부정확한 글이 아예 읽을 수 없는 것보다 나쁠 수 있다고 주장했다. 사람이 작동 원리를 실제보다 잘 안다고 여기는 설명 깊이의 착각(illusion of explanatory depth)도 있다. 그래서 Nardit은 작동 원리가 보인다는 것을 설명이 완전하다는 것과 혼동하지 않으려 조심한다.
이 연구들 가운데 카르파티의 네 형식을 직접 비교한 것은 없다. 그래서 Nardit은 단계가 오를수록 확인이 어려워진다고 주장하지 않고 범위를 좁혀 말한다. 단계마다 주장이 새로운 곳으로 옮겨 간다는 것이다. 산문의 주장은 인용하고 검색할 수 있는 문장에 있다. 다이어그램은 화살표와 빈자리에, 페이지는 코드와 레이아웃에, 영상은 타이밍과 목소리에 주장을 담는다. 확인 작업도 그 자리로 따라가야 하며, 네 형식 중 어느 것도 확인을 대신해 주지 않는다.
속지 않고 네 단계를 쓰는 법
Nardit의 권고는 네 단계를 모두 쓰되, 단계마다 확인할 수 있는 것 하나를 남겨 두라는 것이다. 간이 영어로 쓰게 할 때는 다음을 지킨다.
- 단순화한 버전을 받아 원문 옆에 둔다. 단순화는 대체물이 아니라 또 하나의 보기 방식이어야 한다.
- 식별자, 매개변수 이름, 오류 문자열, 기술 용어는 그대로 두고, “if”, “unless”, “not verified” 같은 말을 모두 남기라고 지시한다. 단순화할 때 가장 먼저 빠지는 말들이다.
- 문체가 중요하면 모델의 말이 아니라 린터로 확인한다.
다이어그램은 텍스트 형식으로 받아 렌더링을 보고, 화살표마다 한 문장씩 적은 목록을 읽는다. HTML은 가정을 바꿔 볼 수 있고 가정이 나열된 페이지를 요청하되, 실제 시스템은 따로 테스트한다. 영상은 대본을 텍스트로 보관해 보기 전에 한 번 읽고, 개인 자료는 호스팅 내레이션에 넣지 않는다.
그리고 실제로 행동에 옮길 내용이라면 결론을 떠받치는 주장 하나를 골라 1차 출처와 대조한다. 요약 이미지의 오류도 그렇게 드러났다. 사전 항목 하나를 한 번 들여다보는 것으로 충분했다.
일이 옮겨 가는 곳
카르파티의 게시물이 그리는 변화는 귀한 능력이 결과물을 만드는 쪽에서 판단하는 쪽으로 옮겨 간다는 것, 그리고 모델이 그 판단도 돕는다는 것이다. 손으로는 만들 가치가 없던 산출물, 곧 쓰고 버리는 설명서, 한 번 쓰는 인터랙티브 페이지, 한 사람을 위한 영상이 실제로 가능해졌다.
Nardit은 여기에 게시물이 드러내지 않은 구분 하나를 더한다. 이해했다는 느낌은 그것이 정확하다는 증거가 아니다. 네 단계 사다리는 앞의 것을 만드는 데 아주 뛰어나지만, 뒤의 것은 어떤 형식을 고르든 일부러 챙겨 넣어야 한다. 이번 주 가장 널리 공유된 명확한 글쓰기 표준 요약이, 가장 명확한 레이아웃으로 그 표준의 교육용 예시 하나를 거꾸로 가르쳤다. Nardit은 보기 좋은 결과물 옆에 1차 출처를 늘 열어 두겠다고 말한다.
출처
- Andrej Karpathy, X 게시물(2026-10-02). https://x.com/karpathy/status/2105819303471976479
- Max Nardit, 「Karpathy on understanding LLM outputs: ASD-STE100 Simplified Technical English, diagrams, HTML and explainer videos, fact-checked」(2026-10-04). https://max.nardit.com/articles/karpathy-understanding-llm-outputs