767 / 774
카르파티가 본 LLM 능력 인식의 깔때기, 60억 명과 5,000명 사이
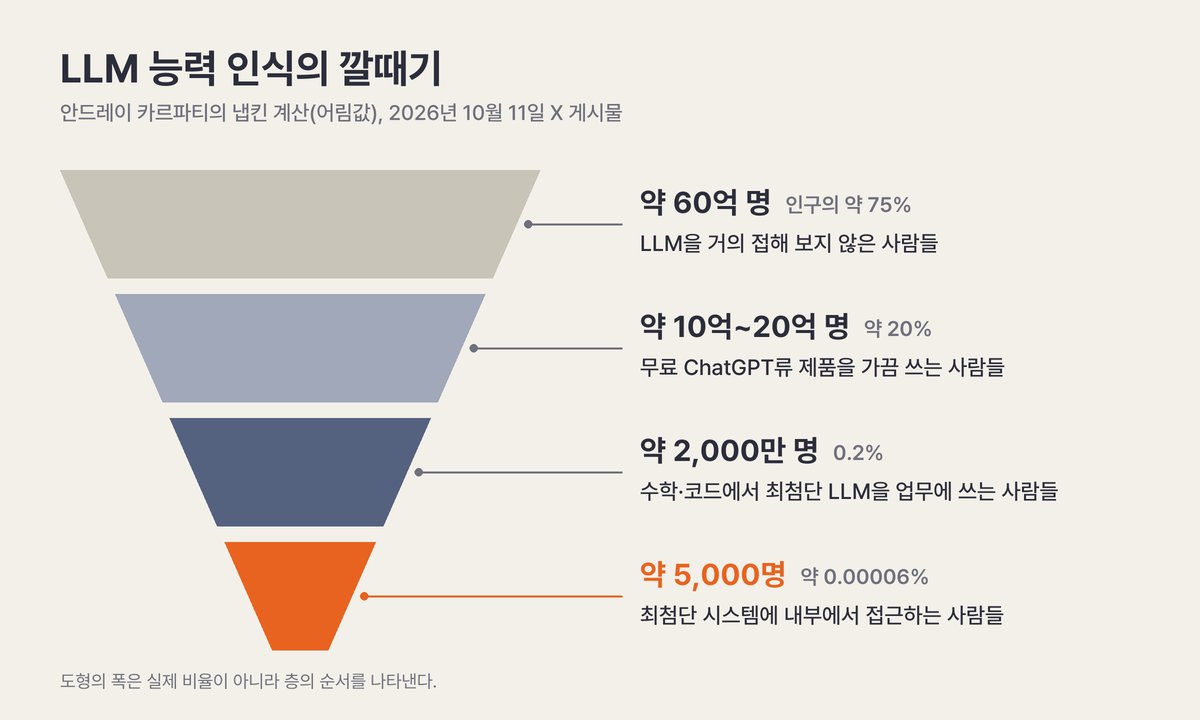
안드레이 카르파티(Andrej Karpathy)는 2026년 10월 11일 X에 올린 글에서 LLM의 능력을 두고 사람들이 공유하는 이해의 격차가 갈수록 벌어지고 있다고 썼다. 그는 이 차이가 이제 서로 말이 엇갈리는 두 집단이라기보다 가파른 깔때기에 가깝다고 보고, LLM을 얼마나 깊이 쓰는지에 따라 사람들을 네 층으로 나눴다. 가장 넓은 층에는 LLM을 거의 접해 보지 않은 약 60억 명이, 가장 좁은 끝에는 최첨단 시스템을 내부에서 쓰는 약 5,000명이 있다. 층마다 붙인 인원과 비율은 카르파티 본인이 냅킨 계산(napkin math)이라고 밝힌 어림값이다.
4월에 쓴 트윗을 다시 꺼내다
이번 글은 카르파티가 2026년 4월 9일에 쓴 트윗을 인용하며 덧붙인 것이다. 그사이 격차가 더 벌어졌다는 것이 그가 4월 트윗을 다시 꺼낸 이유다.
4월 트윗에서 카르파티는 자기 타임라인을 보면 AI 능력에 대한 이해의 격차가 커지고 있다며 사람들을 두 집단으로 나눴다. 한쪽은 지난해쯤 무료 ChatGPT를 써 보고 그 경험에 지나치게 기대어 AI를 판단하는 사람들이다. 이들은 모델의 엉뚱한 버릇이나 환각을 보며 웃는다. 다른 한쪽은 OpenAI Codex나 Claude Code 같은 최첨단 에이전트 모델에 돈을 내고, 프로그래밍·수학·연구 같은 기술 분야에서 업무로 쓰는 사람들이다. 그는 두 집단이 서로 말이 엇갈리고 있다고 정리했다. 10월 글은 이 두 집단 구도를 네 층의 깔때기로 다시 그린 것이다.
깔때기의 네 층
| 층 | 인원(비율) | 카르파티의 묘사 |
|---|---|---|
| LLM을 거의 접하지 않은 사람 | 약 60억 명(인구의 약 75%) | LLM을 거의 접해 본 적이 없다. |
| 무료 제품을 가끔 쓰는 사람 | 약 10억~20억 명(약 20%) | 무료 ChatGPT류 제품을 가끔 가볍게 쓴다. 어설픈 챗봇을 조금 나은 구글 검색이나 글쓰기 보조 도구쯤으로 대한다. |
| 수학·코드에서 최첨단 LLM을 업무에 쓰는 사람 | 약 2,000만 명(0.2%) | 몇 주, 몇 달 걸리던 크고 복잡한 프로젝트를 이제 에이전트가 프롬프트 하나로 끝내는 것을 직접 본다. |
| 최첨단 시스템에 내부에서 접근하는 사람 | 약 5,000명(약 0.00006%) | 수천 개 에이전트의 군집이 몇 주에 걸쳐 협업하는 모습을 본다. 인간의 검토와 이해는 뒤처지기 시작했다. |
약 60억 명, 거의 접해 보지 않은 사람들
카르파티의 어림으로 약 60억 명, 세계 인구의 약 75%는 LLM을 거의 접해 본 적이 없다.
약 10억~20억 명, 무료 챗봇을 가끔 쓰는 사람들
약 10억~20억 명(약 20%)은 무료 ChatGPT류 제품을 가끔 가볍게 쓴다. 이들이 보는 것은 어설픈(derpy) 챗봇이고, 이를 조금 나은 구글 검색이나 글쓰기 보조 도구쯤으로 대한다. 에이전트가 항공권 예약을 시도해 주는 정도를 겪어 봤을 수도 있다. 카르파티는 기술 분야 밖의 친구들 가운데 LLM이 별로 쓸모가 없다고 말하는 사람들이 있고, 자기가 보기에 그 말에도 일리가 있다고 덧붙였다.
수학·코드 밖의 전문직도 상당수가 이 층에 속한다. 그는 임원을 비롯해 여러 직무에 있는 사람들이 다른 사람과 대화하는 데 많은 시간을 쓴다는 점을 예로 들었다. 그래서 이들은 무슨 일이 벌어지는지 머리로는 이해해도, 그 이해가 여전히 간접적이고 다소 추상적이다.
약 2,000만 명, 수학·코드에서 최첨단 LLM을 업무에 쓰는 사람들
여기서부터는 수학·코드 분야에서 최첨단급(frontier-grade) LLM을 업무로 쓰는 사람들이다. 약 2,000만 명(0.2%)인 이들은 예전에 몇 주, 몇 달씩 걸리던 크고 복잡한 프로젝트를 이제 에이전트가 프롬프트 하나로 끝내는 것을 직접 본다. 앱 제작, 앱 복제, 앱 번역, 바이너리에서 앱을 역컴파일하는 일이 그 예다.
카르파티는 이 모든 일이 아주 빠르게, 그리고 최근에 일어났다고 썼다. 1년이 채 안 된 시점까지만 해도 그는 외워 둔 코드 명령어를 코드 편집기에 한 글자씩 손으로 입력하며 코드를 짰고, 가끔 Tab을 눌러 짧은 코드 조각을 자동 완성했다.
약 5,000명, 최첨단 시스템에 내부에서 접근하는 사람들
마지막 층은 최첨단급 시스템에 내부에서 접근하는 약 5,000명(약 0.00006%)이다. 바깥세상이 본 것은 그 미리보기다. 카르파티에 따르면 그 모습은 수천 개 에이전트의 군집이 몇 주에 걸쳐 거대한 소프트웨어 프로젝트에서 협업하는 것이다. 제로데이 취약점을 찾아내고, 기계의 속도로 사이버 공격과 방어를 수행하고, 새로운 과학을 발견하고, 수학의 최전선을 넓힌다. 업계 최고 전문가들이 몇 년을 들였을 일들이다.
그사이 인간의 검토와 이해는 뒤처지기 시작했다. 카르파티는 그 예로 여러 달 전에 있었던 OpenAI-HF 사건을 두고 사람들이 아직도 ‘고고학’을 하고 있다는 점, 그리고 수학자들이 최첨단 수학을 다룬 원고 722편을 한동안 붙들고 있을지 모른다는 점을 들었다. 게시물에는 두 사례에 대한 설명이 따로 없다.
사람이 LLM의 출력을 이해하는 일은 카르파티가 10월 2일 X에 올린 게시물의 주제이기도 하다. 그 내용은 카르파티가 권한 AI 출력 형식 4단계에서 정리했다.
깔때기를 만드는 세 요인
카르파티는 이 깔때기가 여러 요인이 겹쳐 생긴다고 보고 세 가지를 꼽았다.
- 야심, 문제의 크기, 시간 범위. 영향은 이 셋이 커질수록 커진다. 한 문단으로 답할 질문은 시스템에 거의 부담을 주지 않는다. 정말 신경 쓰는 크고 어려운 문제를 넉넉히 쌓아 두고 있어야 한다. 이 요인이 깔때기의 소비자·전문가 축을 만든다.
- 시스템의 들쭉날쭉함(jaggedness). 카르파티가 따로 여러 번 쓴 주제다. 능력은 디지털이고, 검증할 수 있고, 경제적 가치가 큰 분야에서 정점을 찍는다. LLM의 능력이 수익 잠재력에 따라 골라 짠 환경 조합 위에서, 검증 가능한 보상을 쓰는 강화학습으로 생겨나기 때문이다. 이 요인은 주로 깔때기의 분야 축(예를 들어 수학·코드)을 만든다.
- 접근 권한. 무료, 유료, 내부의 차이다.
검증 가능한 보상이 무엇인지는 4월 트윗에 예가 나온다. 코드는 단위 테스트를 통과했는지 아닌지로 판정할 수 있지만, 글쓰기는 명시적으로 판정하기가 훨씬 어렵다. 그는 같은 트윗에서 이런 기술 분야가 B2B 환경에서 훨씬 가치가 커서 기업 팀 인력의 가장 큰 몫이 그 개선에 쏠린다는 점도 이유로 들었다.
이 모든 일이 동시에
카르파티는 이것을 지금 이 순간의 기묘함이라고 불렀다. 일반 대중 대부분은 이런 시스템을 써 본 적이 없고, 써 본 사람에게도 어설픈 챗봇으로 보인다. 전문직 대다수는 아직 소폭의 향상만 체감한다. 그리고 전문직 가운데 아주 얇은 층은 곡선이 수직으로 치솟는 데서 오는 현기증을 겪고 있다. 이 모든 일이 같은 시기에 벌어지고 있다.
출처
- 원문: Andrej Karpathy, X 게시물(2026-10-11). https://x.com/karpathy/status/2109361546505966046
- 원문이 인용한 트윗: Andrej Karpathy, X 게시물(2026-04-09). https://x.com/karpathy/status/2042334451611693415
- 경유: GeekNews, 「LLM의 능력에 대한 인식 격차가 커지고 있다」. https://news.hada.io/topic?id=35202
- 참고: 新智元, PANews 기사(중국어). https://www.panewslab.com/zh/articles/01a12ed2-0425-72c0-9b29-bad50668529a