779 / 780
사고의 연쇄(CoT)는 GPT의 과학 서술형 자동채점을 정확하게 만드는가?
1. 연구의 목적
(1) 서술형 응답 자동채점은 오래 연구돼 왔지만 학교 현장까지 오지 못했음. 연구진이 꼽은 걸림돌은 셋임. 문항마다 사람이 채점한 자료로 모델을 학습시켜야 해서 접근이 어렵고, 기술적으로 복잡하며, 왜 그 점수인지 설명하지 못함.
(2) 이 연구는 GPT-3.5와 GPT-4에 프롬프트만으로 과학 서술형 응답을 채점하게 하고, 사고의 연쇄(Chain-of-Thought, CoT)가 정확도와 설명 가능성을 얼마나 높이는지 검증함. 연구 질문은 넷임. LLM이 채점 근거를 설명할 수 있는가, 제로샷과 퓨샷 중 무엇이 나은가, CoT는 정확도에 기여하는가, GPT-4와 GPT-3.5는 샘플링 방식에 따라 어떻게 다른가.
2. 연구의 방법
(1) 자료는 미국 중학생이 과학 현상을 설명하는 모형을 서술한 기존 데이터셋(Zhai, He, & Krajcik, 2022)을 재분석한 것임. 6개 과제 모두 NGSS 성취기대 MS-PS1-4(열에너지가 더해지거나 빠질 때 입자 운동·온도·상태 변화를 예측하는 모형 개발)를 겨냥함. 사람 채점의 채점자 간 일치도는 모든 문항에서 Cohen’s kappa 0.75를 넘었음.
| 과제 | 채점 유형 | 사례 수 | 탁월 | 발전 | 초보 |
|---|---|---|---|---|---|
| R1_2 | 이분 | 240 | 120 | - | 120 |
| J2_2 | 이분 | 240 | 120 | - | 120 |
| J6_2 | 이분 | 240 | 120 | - | 120 |
| H4_2 | 삼분 | 310 | 110 | 80 | 120 |
| H4_3 | 삼분 | 360 | 120 | 120 | 120 |
| J6_3 | 삼분 | 260 | 20 | 120 | 120 |
- 원자료는 초보 수준 응답이 압도적이었음(H4_2는 약 78%). 모두 초보로 찍어도 정확도가 높아 보이는 착시를 막으려고 수준별로 최대 120개씩 균형 있게 추출해 총 1,650개를 만듦.
(2) 여섯 가지 프롬프트 전략을 비교함. 축은 예시 유무(제로샷 ZS / 퓨샷 FS), CoT 유무, 문항 맥락과 루브릭 제공 여부(CR)임.
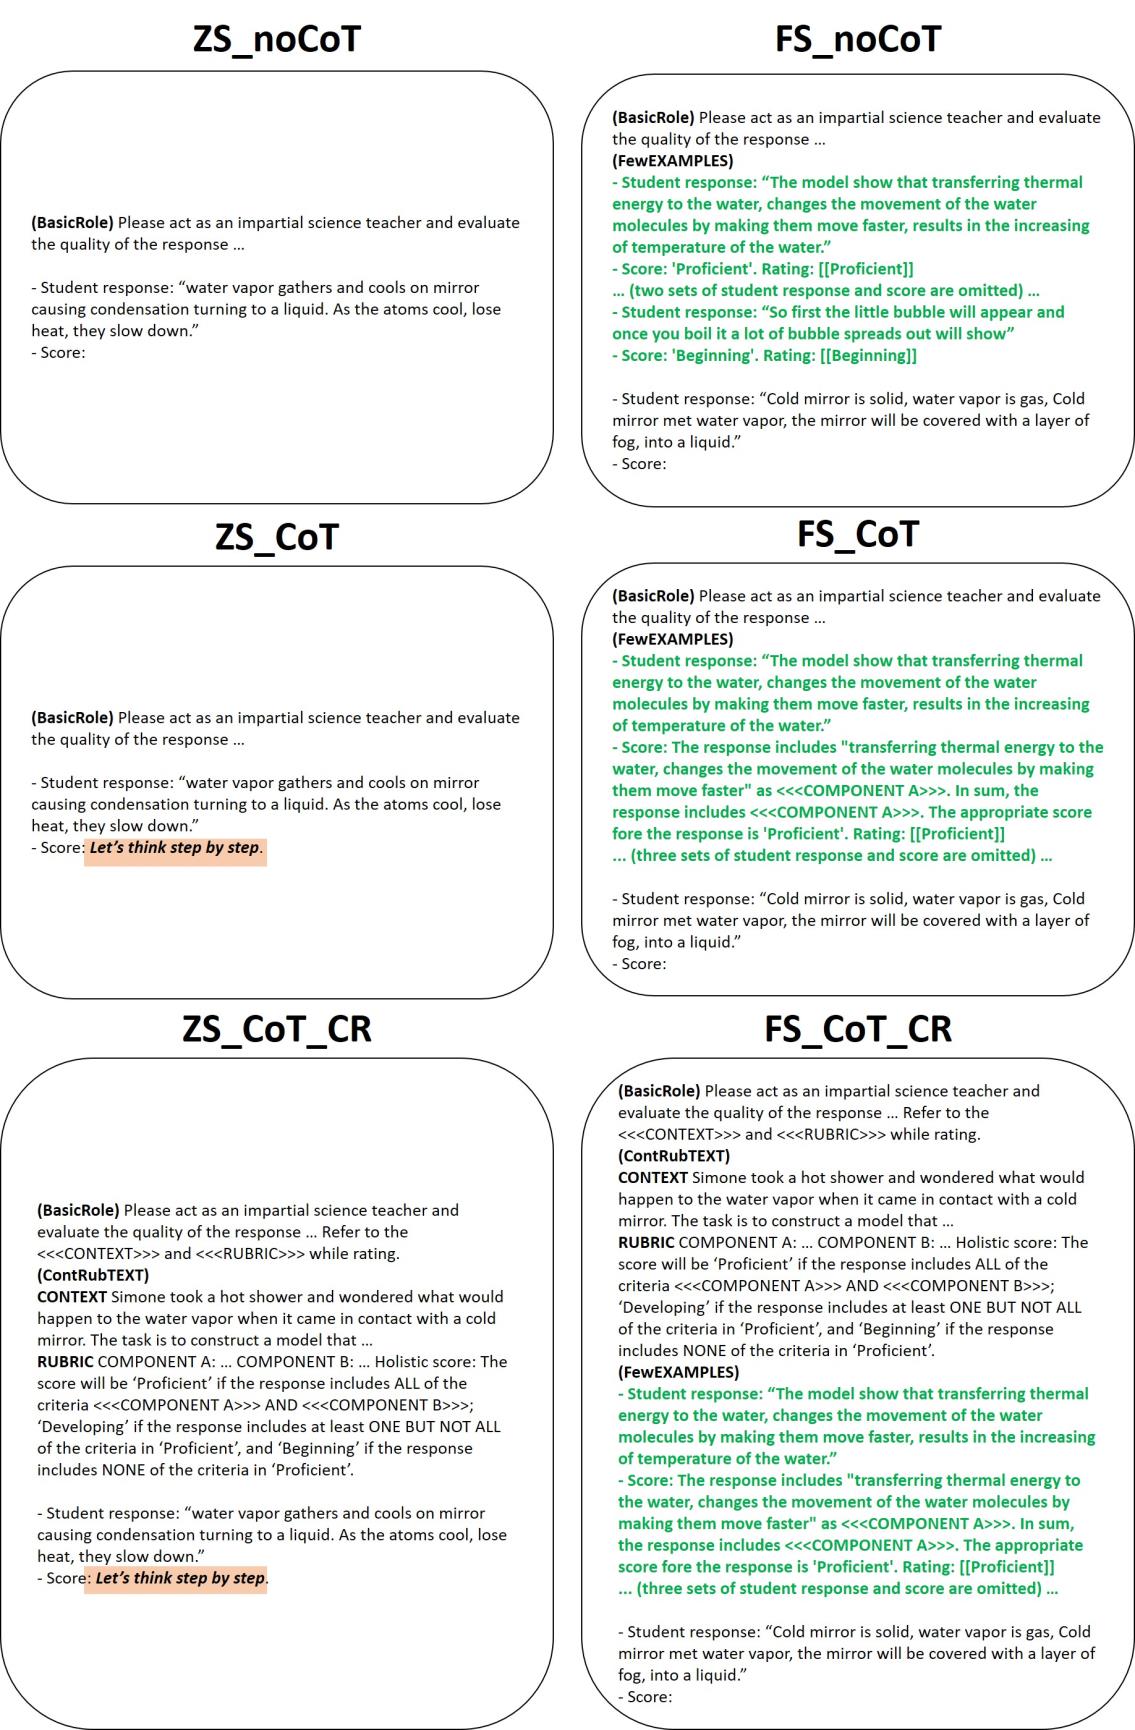
(3) 프롬프트는 연구진이 WRVRT라 이름 붙인 반복 절차로 만듦. 작성(Write), 교육 전문가와 AI 전문가의 검토(Review), 일부 응답으로 검증(Validate), 수정(Revise), 최종 시험(Test) 순서임. 모델 설정은 GPT-4와 GPT-3.5 각각에 대해 한 번 호출하는 그리디 샘플링(temperature 0)과 세 번 호출해 다수결하는 앙상블 투표(temperature 0.9)를 비교함.
3. 주요 발견
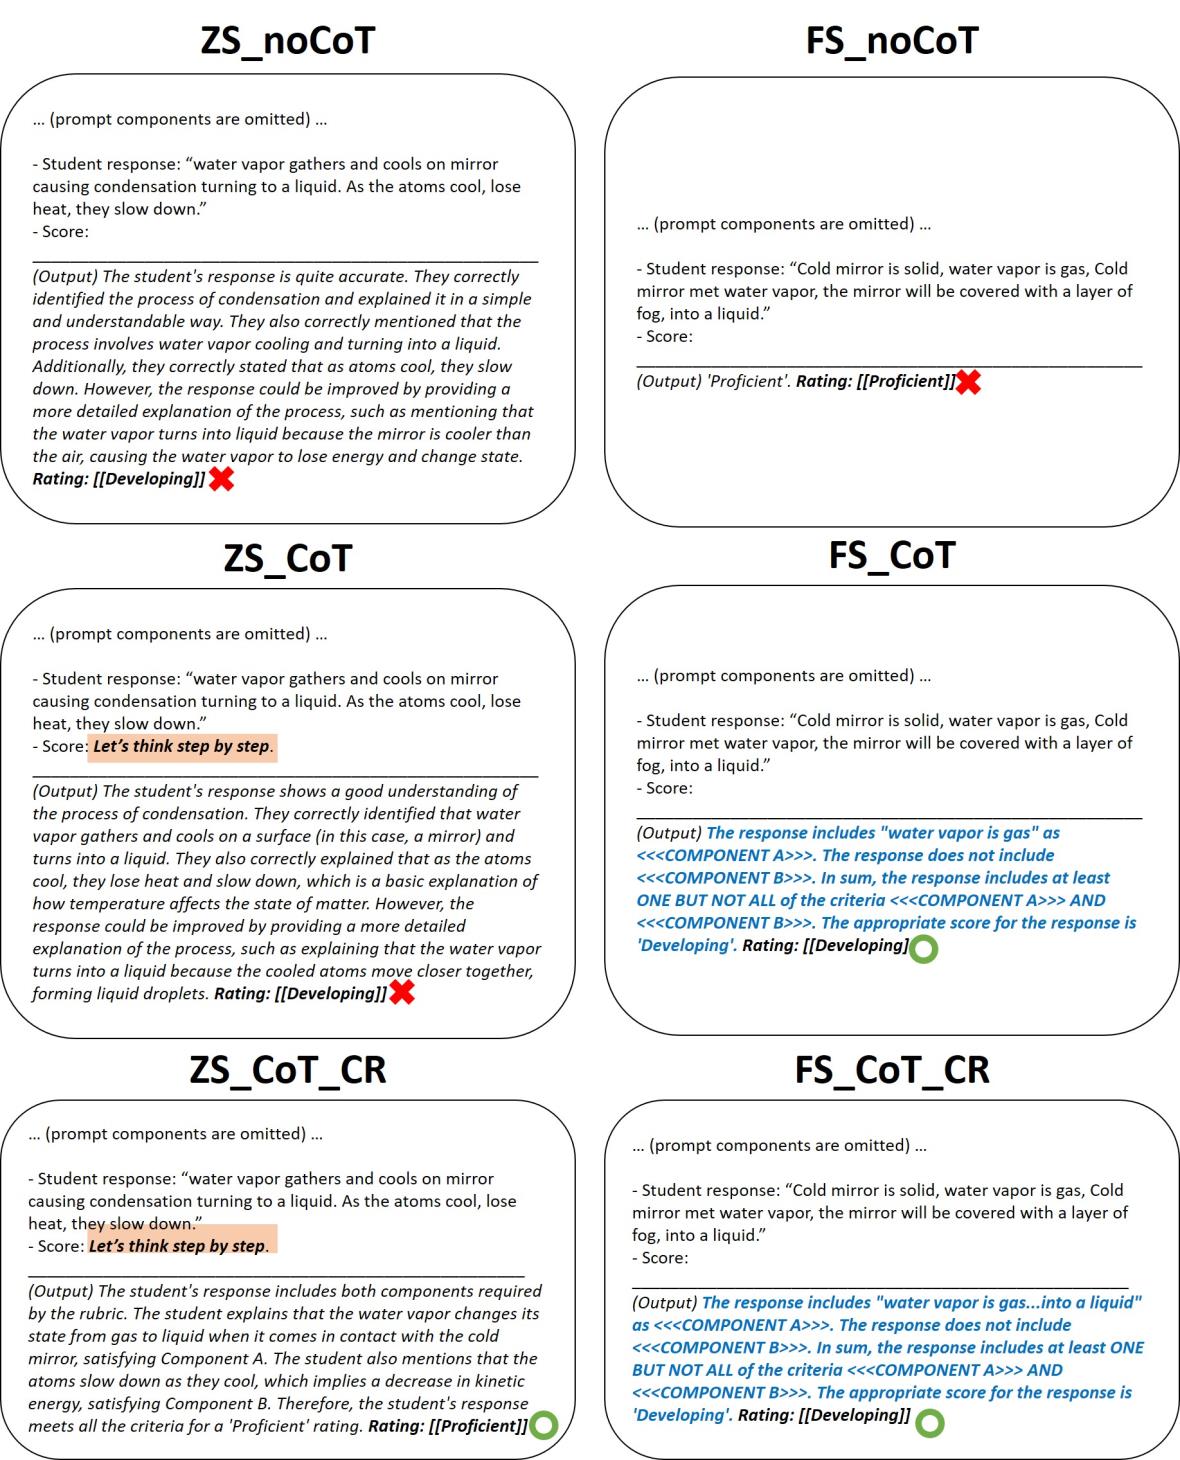
(1) LLM은 점수와 함께 채점 근거를 자연어로 내놓음. 제로샷 프롬프트는 길고 자유로운 평가문을, 퓨샷 프롬프트는 예시의 구조를 따라 어느 루브릭 요소를 충족했는지 짚는 짧은 설명을 생성함.
(2) 전략별 GPT-4 정확도는 다음과 같음.
| 과제 | ZS_noCoT | ZS_CoT | ZS_CoT_CR | FS_noCoT | FS_CoT | FS_CoT_CR |
|---|---|---|---|---|---|---|
| R1_2(이분) | 0.6625 | 0.6458 | 0.7583 | 0.7833 | 0.7500 | 0.7625 |
| J2_2(이분) | 0.6417 | 0.6417 | 0.8458 | 0.7958 | 0.8375 | 0.8792 |
| J6_2(이분) | 0.6583 | 0.6458 | 0.6792 | 0.7833 | 0.8250 | 0.9083 |
| H4_2(삼분) | 0.3613 | 0.3710 | 0.5935 | 0.5581 | 0.5774 | 0.5452 |
| H4_3(삼분) | 0.4722 | 0.5111 | 0.6333 | 0.5917 | 0.6806 | 0.6667 |
| J6_3(삼분) | 0.4962 | 0.5038 | 0.5885 | 0.4500 | 0.2385 | 0.4231 |
| 평균 | 0.5487 | 0.5532 | 0.6831 | 0.6604 | 0.6515 | 0.6975 |
- 단일 최강 전략은 없었고, 이분 채점 문항(최고 0.9083)이 삼분 채점 문항(최고 0.6806)보다 훨씬 잘 맞았음.
(3) 예시를 주는 것만으로 정확도가 올랐음. 제로샷 세 전략의 평균은 0.595, 퓨샷 세 전략의 평균은 0.6698로 12.6% 높았음.
(4) CoT만 단독으로 넣으면 효과가 거의 없었음. 단계별로 생각하라는 지시를 더했을 때 제로샷은 0.5487에서 0.5532로 0.82% 오르는 데 그쳤고, 퓨샷은 0.6604에서 0.6515로 1.35% 떨어졌음. J6_3에서는 퓨샷에 CoT를 더하자 0.4500에서 0.2385로 무너지기도 함.
(5) CoT에 문항 맥락과 루브릭을 함께 주자 결과가 달라졌음. 제로샷은 0.5487에서 0.6831로(13.44%p), 퓨샷은 0.6604에서 0.6975로(3.7%p) 올랐음. 6개 과제 중 5개의 최고 성능이 CoT를 쓴 전략에서 나왔고, 그중 4개가 CoT와 루브릭을 함께 쓴 경우였음.
(6) 루브릭을 곁들인 CoT는 수준별 정확도의 쏠림을 바로잡았음.
- J2_2에서 ZS_CoT를 ZS_CoT_CR로 바꾸자 초보 범주 정확도가 0.40에서 0.8167로 104.2% 올랐고, 탁월 범주는 0.8833에서 0.875로 거의 그대로였음.
- 삼분 채점인 H4_2에서는 효과가 더 컸음. 초보 범주가 0.275에서 0.6833으로, 탁월 범주가 0.1909에서 0.4273으로 오르면서 QWK가 0.2525에서 0.5806으로 뛰었음.
(7) GPT-4가 GPT-3.5를 앞섰고, GPT-4는 한 번 호출이 더 나았음. 아래는 가장 좋은 FS_CoT_CR 프롬프트 기준 평균 정확도임.
| 모델 | 단일 호출(그리디) | 3회 투표(앙상블) |
|---|---|---|
| GPT-4 | 0.6975 | 0.6802 |
| GPT-3.5 | 0.6331 | 0.635 |
- GPT-4는 그리디에서 10.2%, 앙상블에서 4.52% 높아 종합적으로 약 8.64% 우위였음. GPT-3.5에서는 투표가 아주 근소하게 나았음.
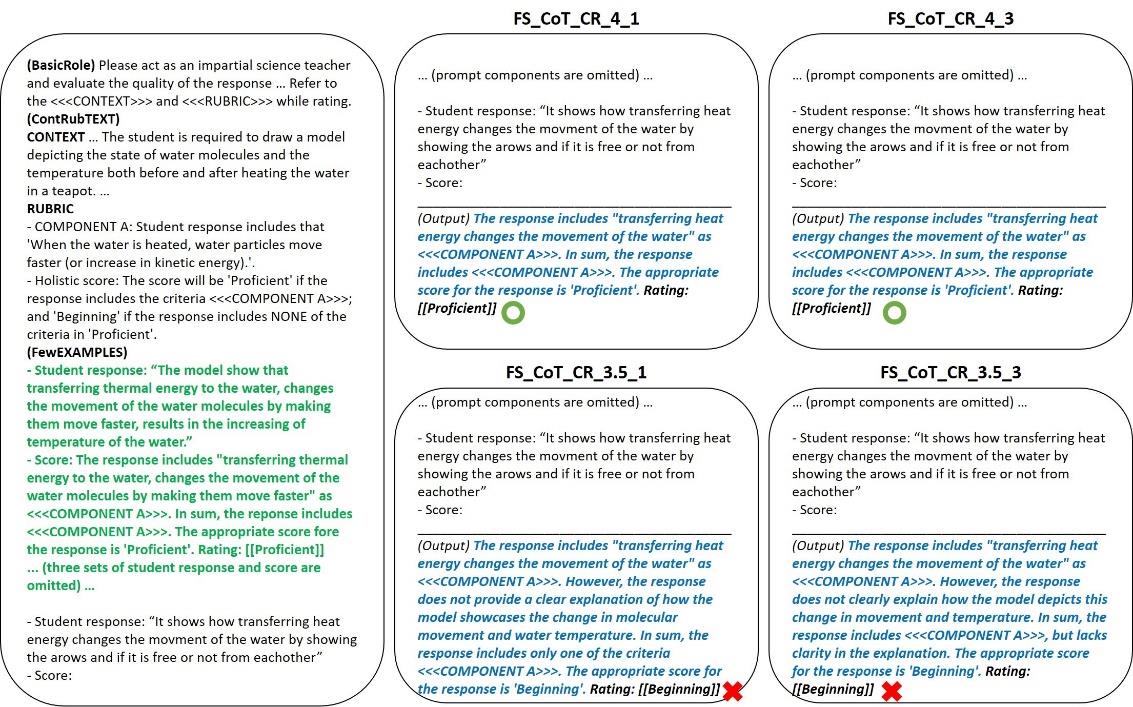
- 응답을 뜯어보니 두 모델은 루브릭을 다르게 썼음. 같은 학생 답에서 둘 다 요소 A를 찾아냈지만, GPT-4는 루브릭 구조대로 채점했고 GPT-3.5는 요소를 찾고도 초보로 채점함. 두 모델 모두 지시가 없었는데도 학생의 철자 오류를 고쳐 읽었음.
4. 결론 및 시사점
(1) 모델 학습 없이 프롬프트만으로 과학 서술형 응답을 채점하고 근거까지 설명할 수 있음을 보였음. 가장 좋은 조합은 GPT-4, 퓨샷, CoT와 루브릭 결합, 단일 호출이었음.
(2) 핵심 교훈은 CoT의 효과가 무엇을 근거로 추론하라고 알려 주느냐에 달려 있다는 점임. 단계별로 생각하라는 일반 지시는 거의 효과가 없었고, 문항 맥락과 루브릭이라는 영역 지식이 붙을 때 정확도와 수준별 균형이 함께 좋아졌음.
(3) 활용 면에서는 프로그래밍 없이 교사와 연구자가 접근할 수 있다는 점, 채점 근거가 드러나 교사가 결과를 검토할 수 있다는 점이 장점임. 다만 삼분 채점 문항의 정확도가 0.6 안팎에 머물러, 고부담 평가가 아닌 형성평가 보조로 쓰는 편이 현실적임. 비용을 따지면 GPT-3.5와 투표 조합도 선택지가 됨.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 가장 주목할 결과는 J6_3의 붕괴임. 퓨샷에 CoT만 더하자 정확도가 0.4500에서 0.2385로 반 토막 났음. 루브릭 없는 추론은 모델이 자기 나름의 채점 기준을 지어내는 과정이 되기 쉬움. 교사가 챗봇에 학생 답을 붙여 넣고 꼼꼼히 생각해서 채점해 달라고만 하는 방식이 위험한 이유가 여기에 있음. 추론을 시키려면 추론의 재료인 루브릭을 반드시 같이 줘야 함.
(2) 인접 분야와 연결하면, 이 연구는 평가 설계의 오래된 원칙을 LLM 시대에 다시 확인함. 증거 중심 평가 설계(ECD)는 학생 응답에서 무엇을 증거로 볼지 미리 정해야 점수가 해석 가능해진다고 봄. 루브릭을 구성요소 A, B로 쪼개 제시한 프롬프트가 잘 작동한 것도 같은 원리임. 좋은 AI 채점의 출발점은 좋은 루브릭이며, 교사의 루브릭 설계 역량이 곧 AI 채점 품질의 상한이 됨.
(3) 발전 아이디어는 세 가지임.
- 첫째, 초등 5·6학년 과학의 물질 상태 변화 단원처럼 같은 계열 성취기준의 한국어 서술형 문항으로 재현함. 한국어 응답의 맞춤법 오류와 구어체가 정확도에 미치는 영향도 함께 봄.
- 둘째, 삼분 채점의 중간 범주(발전)에 오분류가 몰리는지 분석하고, 중간 범주만 사람이 확인하는 선별 검토 방식의 효율을 측정함.
- 셋째, 모델이 낸 채점 근거를 학생에게 피드백으로 돌려줬을 때 오개념 수정에 도움이 되는지 확인함. 채점용 설명과 학습용 피드백은 같은 글이 아닐 수 있음.
6. 추가 탐구 질문
(1) 루브릭의 구성요소를 더 잘게 쪼개 줄수록 LLM 채점은 계속 정확해지는가, 아니면 어느 지점에서 오히려 떨어지는가?
(2) 최신 추론 모델에서도 루브릭 없는 CoT의 효과는 여전히 미미한가?
(3) 이분 채점보다 삼분 채점에서 정확도가 크게 떨어지는 이유는 모델의 한계인가, 아니면 사람 채점 기준 자체의 경계 모호성인가?
출처
- Lee, G.-G., Latif, E., Wu, X., Liu, N., & Zhai, X. (2024). Applying large language models and chain-of-thought for automatic scoring. Computers and Education: Artificial Intelligence, 6, 100213. https://doi.org/10.1016/j.caeai.2024.100213
- 리뷰에 사용한 원고: arXiv:2312.03748v2. https://arxiv.org/abs/2312.03748