780 / 780
GPT-4는 학생의 과학 실험 보고서에서 탐구 오류를 찾아낼 수 있는가?
1. 연구의 목적
(1) 학생은 실험을 설계하고 수행하는 과정에서 반복되는 오류를 보임. 가설에 종속변수가 없거나, 대조 실험을 빠뜨리거나, 관찰을 그대로 결론으로 적는 식임. 이런 오류는 이미 잘 정리돼 있지만, 교사가 학생마다 실험 기록지를 읽고 짚어 주기에는 시간이 부족하고 판단의 일관성도 보장되지 않음.
(2) 실험 기록지는 불완전하고 때로 모순되며 학생마다 형식이 제각각인 자료임. 이 연구는 GPT-3.5와 GPT-4 기반 AI 시스템이 이런 자료에서 학생의 탐구 오류를 자동으로 찾아낼 수 있는지, 그 판단이 인간 평가자와 얼마나 일치하는지 검증함. 교사의 평가를 덜어 주고 학생에게 즉각적인 피드백을 줄 도구의 기반을 마련하려는 목적임.
2. 연구의 방법
(1) 독일 남부 중등학교 6~8학년 37명이 쓴 실험 기록지 65개를 분석함. 기록지는 가설, 재료, 실험 장치 스케치, 수행 과정, 관찰, 결과 칸으로 구성됨. 학생들은 대학 조교의 감독 아래 개별로 두 과제 중 하나를 수행함.
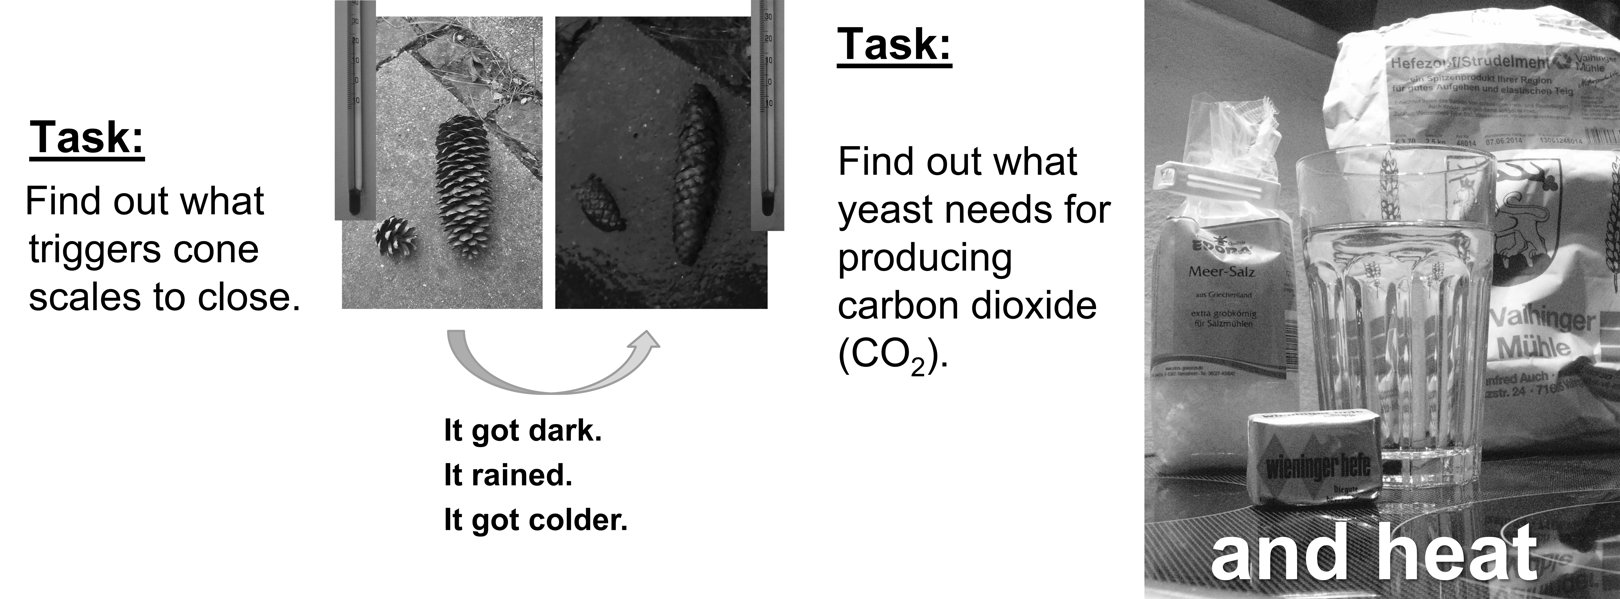
(2) 자료는 용도별로 나눠 씀.
| 용도 | 기록지 수 | 구성 |
|---|---|---|
| AI 시스템 개발·수정 | 25 | 솔방울 10, 효모 15 |
| AI와 인간 평가자 일치도 산출 | 40 | 솔방울 20, 효모 20 |
| 인간 평가자 3인 간 일치도 산출 | 15 | 위 40개 중 일부 |
- 표본은 과제, 성별, 학년, 학업 성취(상·중·하)가 고르게 섞이도록 구성함. 인간 평가자는 과학교육 전문가 2명(생물, 물리)과 컴퓨터과학 전문가 1명임.
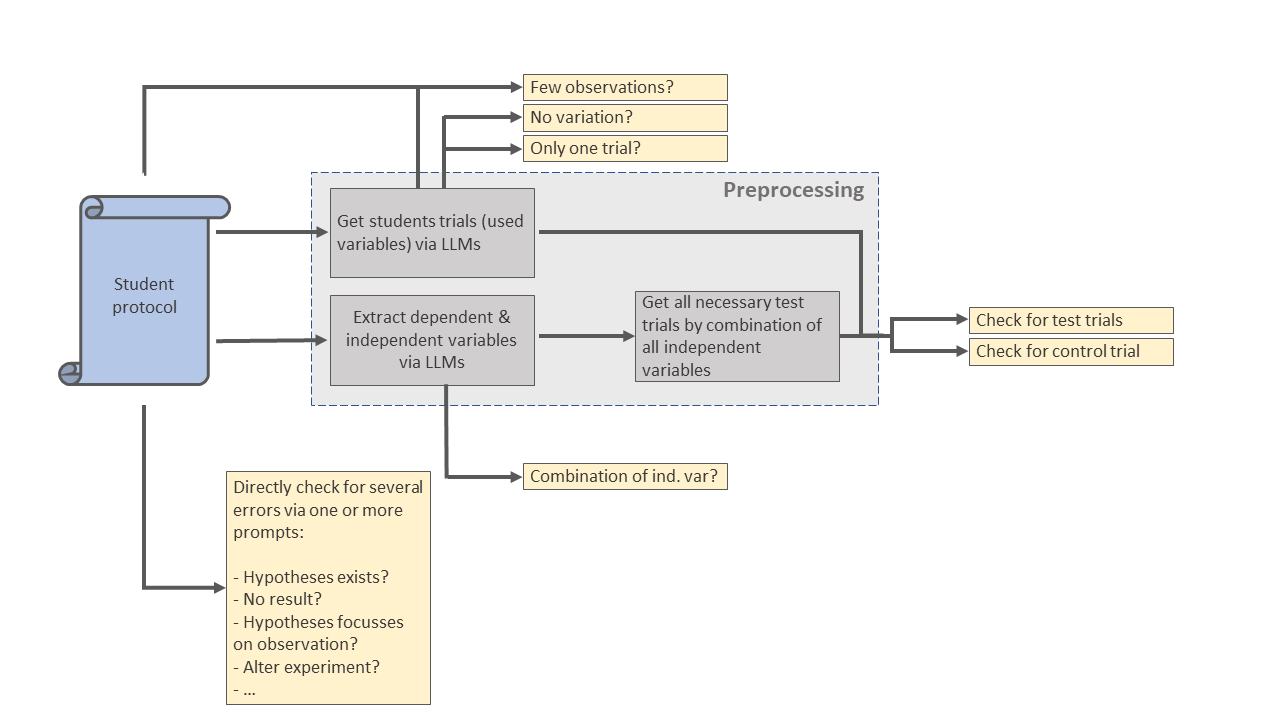
(3) AI 시스템은 비디오 분석용으로 개발된 기존 오류 평정 체계(16개 오류)를 바탕으로 만듦. 2023년 6월 버전 GPT-3.5와 GPT-4에 과학 교사 역할 부여와 사고의 연쇄(CoT) 프롬프트를 적용함. 일부 오류는 프롬프트로 바로 판정하고, 일부는 LLM이 가설에서 독립·종속변수를 뽑고 학생이 실제로 수행한 시행을 정리한 뒤 알고리즘으로 대조해 판정함. 예컨대 가설의 독립변수를 모두 조합하면 몇 개의 시행이 필요한지 계산하고 실제 시행과 맞춰 보는 방식임.
(4) 일치도는 정확도, Cohen’s/Fleiss’ kappa, Gwet’s AC1로 측정함. kappa는 오류가 극히 드물거나 흔하면 정확도가 높아도 낮게 나오는 한계가 있어 AC1을 함께 봄.
3. 주요 발견
(1) 인간 평가자끼리도 모든 오류에서 일치하지는 않았음. 최소 정확도는 0.71(내용이 같은 시행)에서 1.00 사이였고, 한 번만 시행함이나 내용이 같은 시행 같은 오류는 사람끼리도 판단이 갈렸음.
(2) AI와 인간의 일치도는 오류 유형에 따라 크게 갈렸음. 정확도는 0.38에서 1.00까지 분포함.
| 오류 유형 | 인간 간 정확도(최소~최대) | 인간 간 AC1 | AI 정확도 | AI-인간 κ | AI-인간 AC1 |
|---|---|---|---|---|---|
| 가설이 종속변수가 아닌 예상 관찰에 초점 | 0.94~1.00 | 0.95 | 0.90 | -0.04 | 0.89 |
| 가설이 독립변수의 조합으로 구성 | 0.88~1.00 | 0.85 | 0.90 | 0.80 | 0.80 |
| 가설에 종속변수 없음 | 0.94~1.00 | 0.95 | 0.78 | 0.05 | 0.71 |
| 가설 없음 | 1.00 | 1.00 | 0.92 | 0 | 0.92 |
| 재료 누락 | 1.00 | 1.00 | 1.00 | 계산 불가 | 1.00 |
| 시험 시행 누락 | 0.82~0.94 | 0.76 | 0.82 | 0.62 | 0.68 |
| 대조 시행 누락 | 0.88 | 0.86 | 0.60 | 0.02 | 0.36 |
| 시행을 준비하며 필수 요소를 빠뜨림 | 1.00 | 1.00 | 0.65 | 0.15 | 0.46 |
| 내용이 같은 시행(변인 변화 없음) | 0.71~0.88 | 0.73 | 0.62 | 0.30 | 0.27 |
| 실험 도중 시행을 바꿈 | 0.88~0.94 | 0.89 | 1.00 | 1.00 | 1.00 |
| 한 번만 시행함 | 0.94~1.00 | 0.96 | 0.82 | 0.31 | 0.77 |
| 수행 과정 기록 누락 | 1.00 | 1.00 | 1.00 | 계산 불가 | 1.00 |
| 일부 시행에서만 관찰 | 0.88~1.00 | 0.90 | 1.00 | 1.00 | 1.00 |
| 결과가 변인 진술 없이 가장 잘된 시행에만 초점 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 |
| 관찰이나 가설을 결과로 제시 | 0.88~0.94 | 0.90 | 0.38 | 0.08 | -0.21 |
| 결과 없음 | 1.00 | 1.00 | 0.92 | 0.36 | 0.92 |
- 인간 간 수치는 15개, AI-인간 수치는 40개 기록지 기준임.
- AI가 잘 잡은 것은 구조가 분명한 오류였음. 가설이 독립변수의 조합인지(정확도 0.90, κ 0.80), 실험 도중 시행을 바꿨는지(1.00), 결과가 가장 잘된 시행에만 초점을 맞췄는지(1.00)를 매우 높게 맞춤. 실험 도중 변경 오류는 인간끼리의 일치도(AC1 0.89)보다도 높았음.
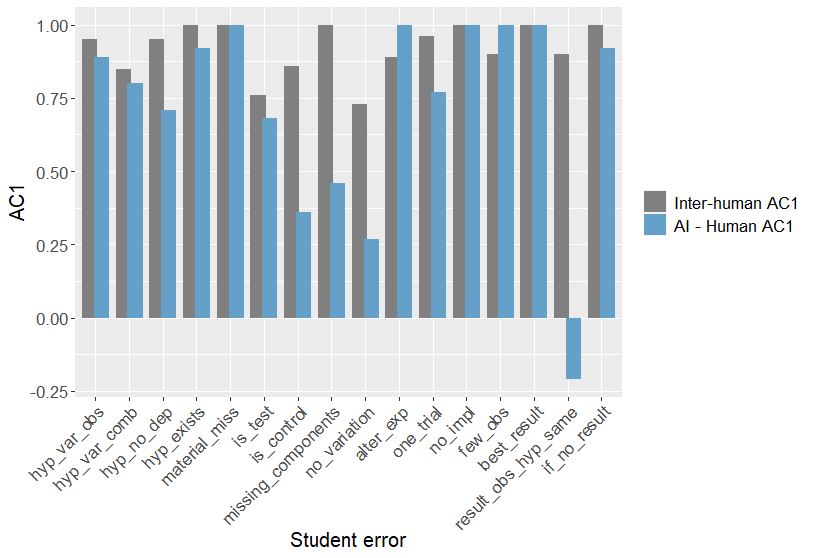
(3) 여러 단계의 추론이 필요한 오류에서는 인간이 크게 앞섰음. 대조 시행 누락(AC1 0.36), 필수 요소 누락(0.46), 내용이 같은 시행(0.27), 관찰이나 가설을 결과로 제시(-0.21)가 그 예임.
- 대조 시행 판정은 세 단계를 거쳐야 함. 가설에서 독립변수를 뽑고, 모든 시행의 변인을 분석하고, 독립변수를 모두 포함한 시행이 하나라도 있는지 확인해야 함.
- 걸림돌은 학생의 표현이었음. 헤어드라이어, 열, 따뜻한 물, 뜨거운 물, 물(뜨거움)이 모두 같은 변인인 열을 뜻했지만, 이름이 조금만 달라져도 AI는 같은 변인으로 묶지 못했음.
- 연구진은 해석 없이 적힌 글만으로 판정하려 했다는 점, 어리거나 경험이 적은 학생일수록 장치를 모호하게 기술한다는 점을 원인으로 듦.
(4) 재현성과 편향에 대한 논의도 남김. temperature를 0으로 둬도 출력이 완전히 결정적이지 않고, GPT-4의 행동이 짧은 기간에 크게 바뀐다는 보고가 있어 정기적인 점검이 필요함. 반면 오류 식별이라는 과제 특성상 편향 문제는 상대적으로 작고, 오히려 인간 평가자의 편향을 줄일 수 있다고 봄.
(5) 한계도 분명함. 두 과제에서만 검증했고, 연구 문제를 미리 제시해 학생이 스스로 탐구 문제를 세우는 단계는 보지 못했음. 독일어 기록지를 영어 프롬프트로 분석해 번역의 영향이 섞였고, 일부 오류는 40개 중 3개 미만으로 드물어 kappa가 낮게 나왔음. 실험실 조건에서 수집해 일반 교실 자료로 검증되지 않았고, 스케치는 분석하지 못함.
4. 결론 및 시사점
(1) 대규모 맞춤 데이터셋 없이 25개 기록지만으로 개발한 LLM 시스템이 기본적인 탐구 오류 다수를 높은 정확도로 찾아냈음. 연구진은 LLM 기반 평가에서는 데이터의 양보다 질과 적합성이 결정적이라고 정리함.
(2) 시스템은 교사를 대신하는 도구가 아니라 하이브리드 지능으로 설계됨. AI가 오류를 표시하고, 수업에서 무엇을 다룰지는 교사가 정함. 학생에게 별도 시험을 부과하지 않고 탐구 과정 안에서 오류를 짚는 방식이라 시험 불안을 줄이는 데도 도움이 될 수 있다고 봄.
(3) 후속 계획은 학생에게 기록지 오류를 즉시 알려 주고 개선 방향을 제안하는 피드백 도구임. 다만 지금 수준에서는 다단계 추론이 필요한 오류를 교사가 반드시 확인해야 함.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 가장 주목할 지점은 AI가 틀린 곳이 곧 탐구 역량의 핵심이라는 사실임. 대조 시행 누락, 변인 통제 실패, 관찰을 결론으로 옮겨 적기는 초등 과학에서도 가장 공들여 가르치는 부분임. 쉬운 오류는 AI가 잘 잡고 정작 중요한 오류는 놓치므로, 이 도구를 쓰면 교사의 시간이 줄어드는 것이 아니라 집중할 곳이 선명해짐. 1차 검토를 AI에 맡기고 대조 실험 판단만 교사가 보는 분업이 현실적인 설계임.
(2) 인접 분야와 연결하면, 변인 이름 문제는 자연어처리의 개체 동일성 판단(같은 대상을 가리키는 서로 다른 표현을 묶는 일)과 같은 과제임. 학생 표현은 헤어드라이어처럼 도구 이름으로, 따뜻한 물처럼 조건으로 흩어짐. 해법의 실마리는 수업 설계 쪽에 있음. 기록지에 독립변수, 바꾼 조건, 같게 한 조건을 적는 칸을 따로 두면 학생의 탐구 사고도 정리되고 AI 판정도 쉬워짐. 평가 도구를 바꾸기 전에 기록지 양식을 바꾸는 편이 싸고 효과적임.
(3) 발전 아이디어는 세 가지임.
- 첫째, 한국 초등 5·6학년 과학의 변인 통제 실험(예: 식물 성장 조건, 용해 속도)으로 같은 시스템을 재현함. 한국어 기록지를 한국어 프롬프트로 분석하면 번역 문제도 걷어낼 수 있음.
- 둘째, 이미지 입력이 가능한 모델로 실험 장치 스케치를 함께 분석함. 학생은 글로 못 쓴 변인을 그림으로 그리는 경우가 많음.
- 셋째, AI가 찾은 오류를 학생에게 바로 알려 주는 조건과 교사를 거쳐 전달하는 조건을 비교해, 다음 실험에서 같은 오류가 줄어드는지 측정함.
6. 추가 탐구 질문
(1) 학생에게 변인 이름을 통일해 쓰도록 안내하면 AI의 대조 시행 판정 정확도는 얼마나 올라가는가?
(2) 최신 모델에서도 관찰이나 가설을 결과로 제시한 오류의 판정이 우연 수준 이하에 머무는가, 아니면 다단계 추론 능력 향상으로 해소되는가?
(3) AI가 즉시 오류를 짚어 주는 환경에서 학생은 스스로 오류를 찾는 연습을 덜 하게 되지 않는가?
출처
- Bewersdorff, A., Seßler, K., Baur, A., Kasneci, E., & Nerdel, C. (2023). Assessing student errors in experimentation using artificial intelligence and large language models: A comparative study with human raters. Computers and Education: Artificial Intelligence, 5, 100177. https://doi.org/10.1016/j.caeai.2023.100177
- 리뷰에 사용한 원고: arXiv:2308.06088v1. https://arxiv.org/abs/2308.06088