778 / 780
LLM 채점 피드백은 초보 채점자를 전문가 수준으로 끌어올리는가?
1. 연구의 목적
(1) 영어를 제2언어로 배우는 학생에게는 즉각적이고 개인화된 피드백이 필요하지만, 교사 한 명이 맡는 학생 수가 많아 현실에서는 어려움. 자동 에세이 채점(AES)이 대안으로 꼽혀 왔으나 과제 맥락이 다양하고 채점 기준이 모호하며, 논리 구조처럼 추상적인 기준에서는 교사 간 판단도 엇갈림.
(2) 이 연구는 GPT-4와 미세조정한 GPT-3.5를 AES 도구로 검증함. 정확성, 일관성, 일반화 가능성, 설명 가능성을 따진 뒤, 한 걸음 더 나아가 LLM이 만든 점수와 설명을 받은 인간 채점자가 더 정확해지는지 실험함. 질문의 축이 채점 자동화에서 채점자 증강으로 옮겨 간 연구임.
2. 연구의 방법
(1) 데이터는 두 종류임.
| 데이터셋 | 규모 | 특징 |
|---|---|---|
| ASAP(공개) | 에세이 12,978편, 과제 8종 | 과제마다 루브릭과 점수 범위가 다름 |
| 중국 고교생 영어 에세이(비공개) | 29개 고교 기말고사 6,559편 | 숙련 교사가 대입 시험 기준으로 내용·언어·구조 3차원 채점, 총점 0~20점 |
(2) 비교한 채점 방식은 다음과 같음. 모든 LLM 설정에 사고의 연쇄(CoT)를 적용해 자료를 먼저 분석하고 설명한 뒤 점수를 정하도록 함.
| 방식 | 내용 |
|---|---|
| GPT-4 제로샷(루브릭 없음) | 과제와 에세이만 제공 |
| GPT-4 제로샷(루브릭 있음) | 채점 기준 추가 제공 |
| GPT-4 퓨샷(루브릭 있음) | 임베딩 유사도로 고른 예시 에세이 3편과 점수 추가 제공 |
| 미세조정 GPT-3.5 | 데이터셋별 미세조정. 비공개 데이터는 4개 점수를 한 번에 내는 멀티태스크형과 차원별 모델을 합친 앙상블형 두 가지 |
| BERT 기준선 | BERT에 소프트맥스 층을 붙인 분류기 |
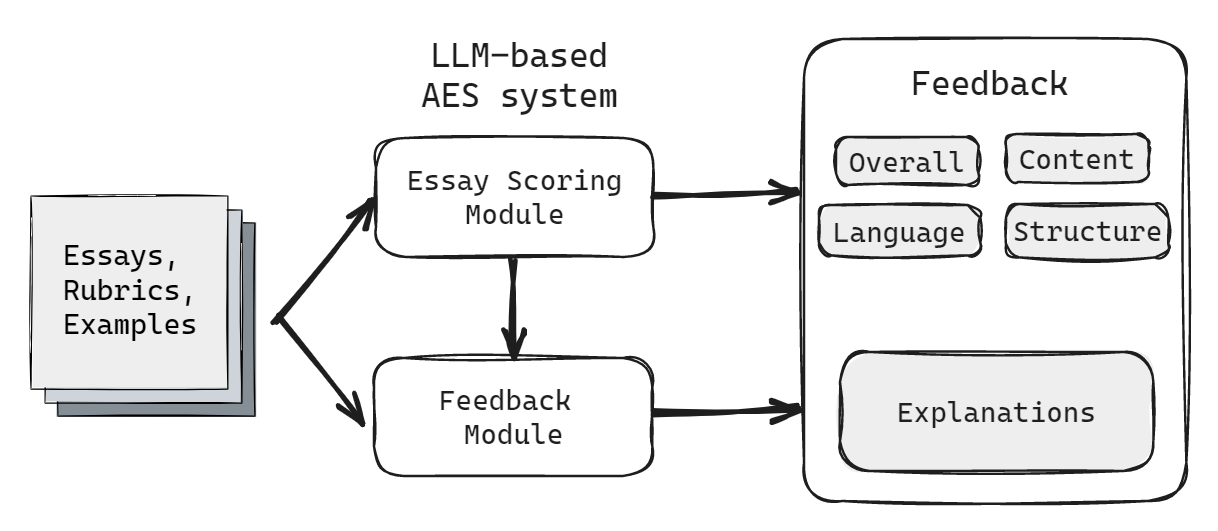
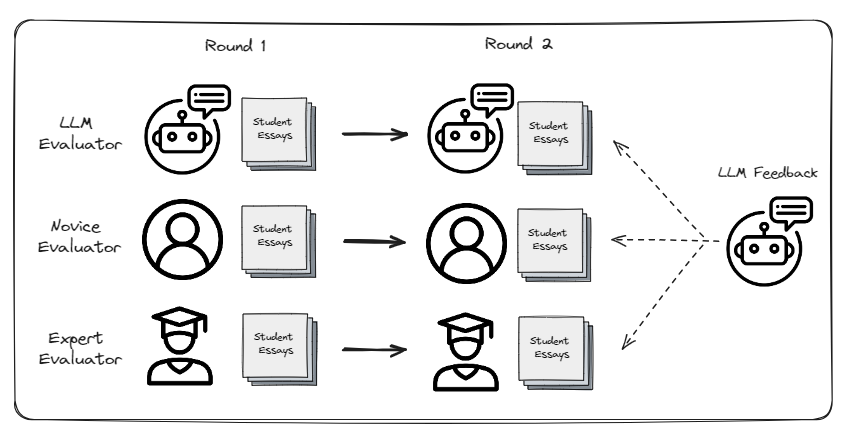
(3) 인간 채점 실험에는 채점 경험이 없는 베이징 사범대생(예비 고교 교사) 10명과 경력 있는 고교 영어 교사 5명이 참여함. 비공개 데이터 시험 세트에서 같은 주제 에세이 50편을 골라 먼저 루브릭만으로 채점하게 한 뒤, 최고 성능 모델(미세조정 GPT-3.5 앙상블)의 점수와 설명을 보여 주고 점수를 고칠 기회를 줌. 같은 피드백을 GPT-4 퓨샷 채점기에도 제공해 비교함.
3. 주요 발견
(1) 미세조정 GPT-3.5가 가장 정확했고, 루브릭을 준 GPT-4 제로샷은 기대에 못 미쳤음. 지표는 인간 점수와의 일치도인 QWK임(1이면 완전 일치, 0이면 우연 수준).
| 방식 | ASAP 8개 세트 평균 QWK | 비공개 데이터 총점 QWK |
|---|---|---|
| GPT-4 제로샷(루브릭 없음) | 0.331 | 0.4688 |
| GPT-4 제로샷(루브릭 있음) | 0.344 | 0.5344 |
| GPT-4 퓨샷(루브릭 있음) | 0.474 | 0.6729 |
| 미세조정 GPT-3.5 | 0.738 | 0.7620(멀티태스크) / 0.7806(앙상블) |
| BERT 기준선 | 0.673 | 0.7250 |
- ASAP 평균은 논문 표 1의 세트별 값을 리뷰어가 평균한 값임. 미세조정 GPT-3.5는 8개 세트 중 6개에서 BERT를 앞섬.
- GPT-4 제로샷은 일부 세트에서 거의 우연 수준이었음(세트 1 QWK 0.0423, 세트 7 0.0809). 루브릭을 추가해도 성능이 크게 오르지 않아, 가장 앞선 모델도 복잡한 인간 지시를 온전히 따르기 어렵다는 점이 드러남.
- 비공개 데이터에서는 차원별 모델을 합친 앙상블이 총점·내용·구조 점수에서 가장 높았음.
(2) 일관성과 일반화도 확인함.
- temperature 0으로 같은 실험을 세 번 반복했을 때 점수의 80% 이상이 바뀌지 않았음.
- 한 세트로 학습하고 나머지 세트에 적용하는 일반화 시험에서 미세조정 GPT-3.5가 대체로 BERT를 앞섬. BERT는 학습한 점수 범위 밖을 예측하지 못해, 예컨대 0~3점 세트로 학습하면 1~6점 세트의 4~6점을 맞히지 못했음. 다만 세트 4로 학습해 세트 1·7에 적용한 경우처럼 GPT-3.5가 밀린 예외도 있었음.
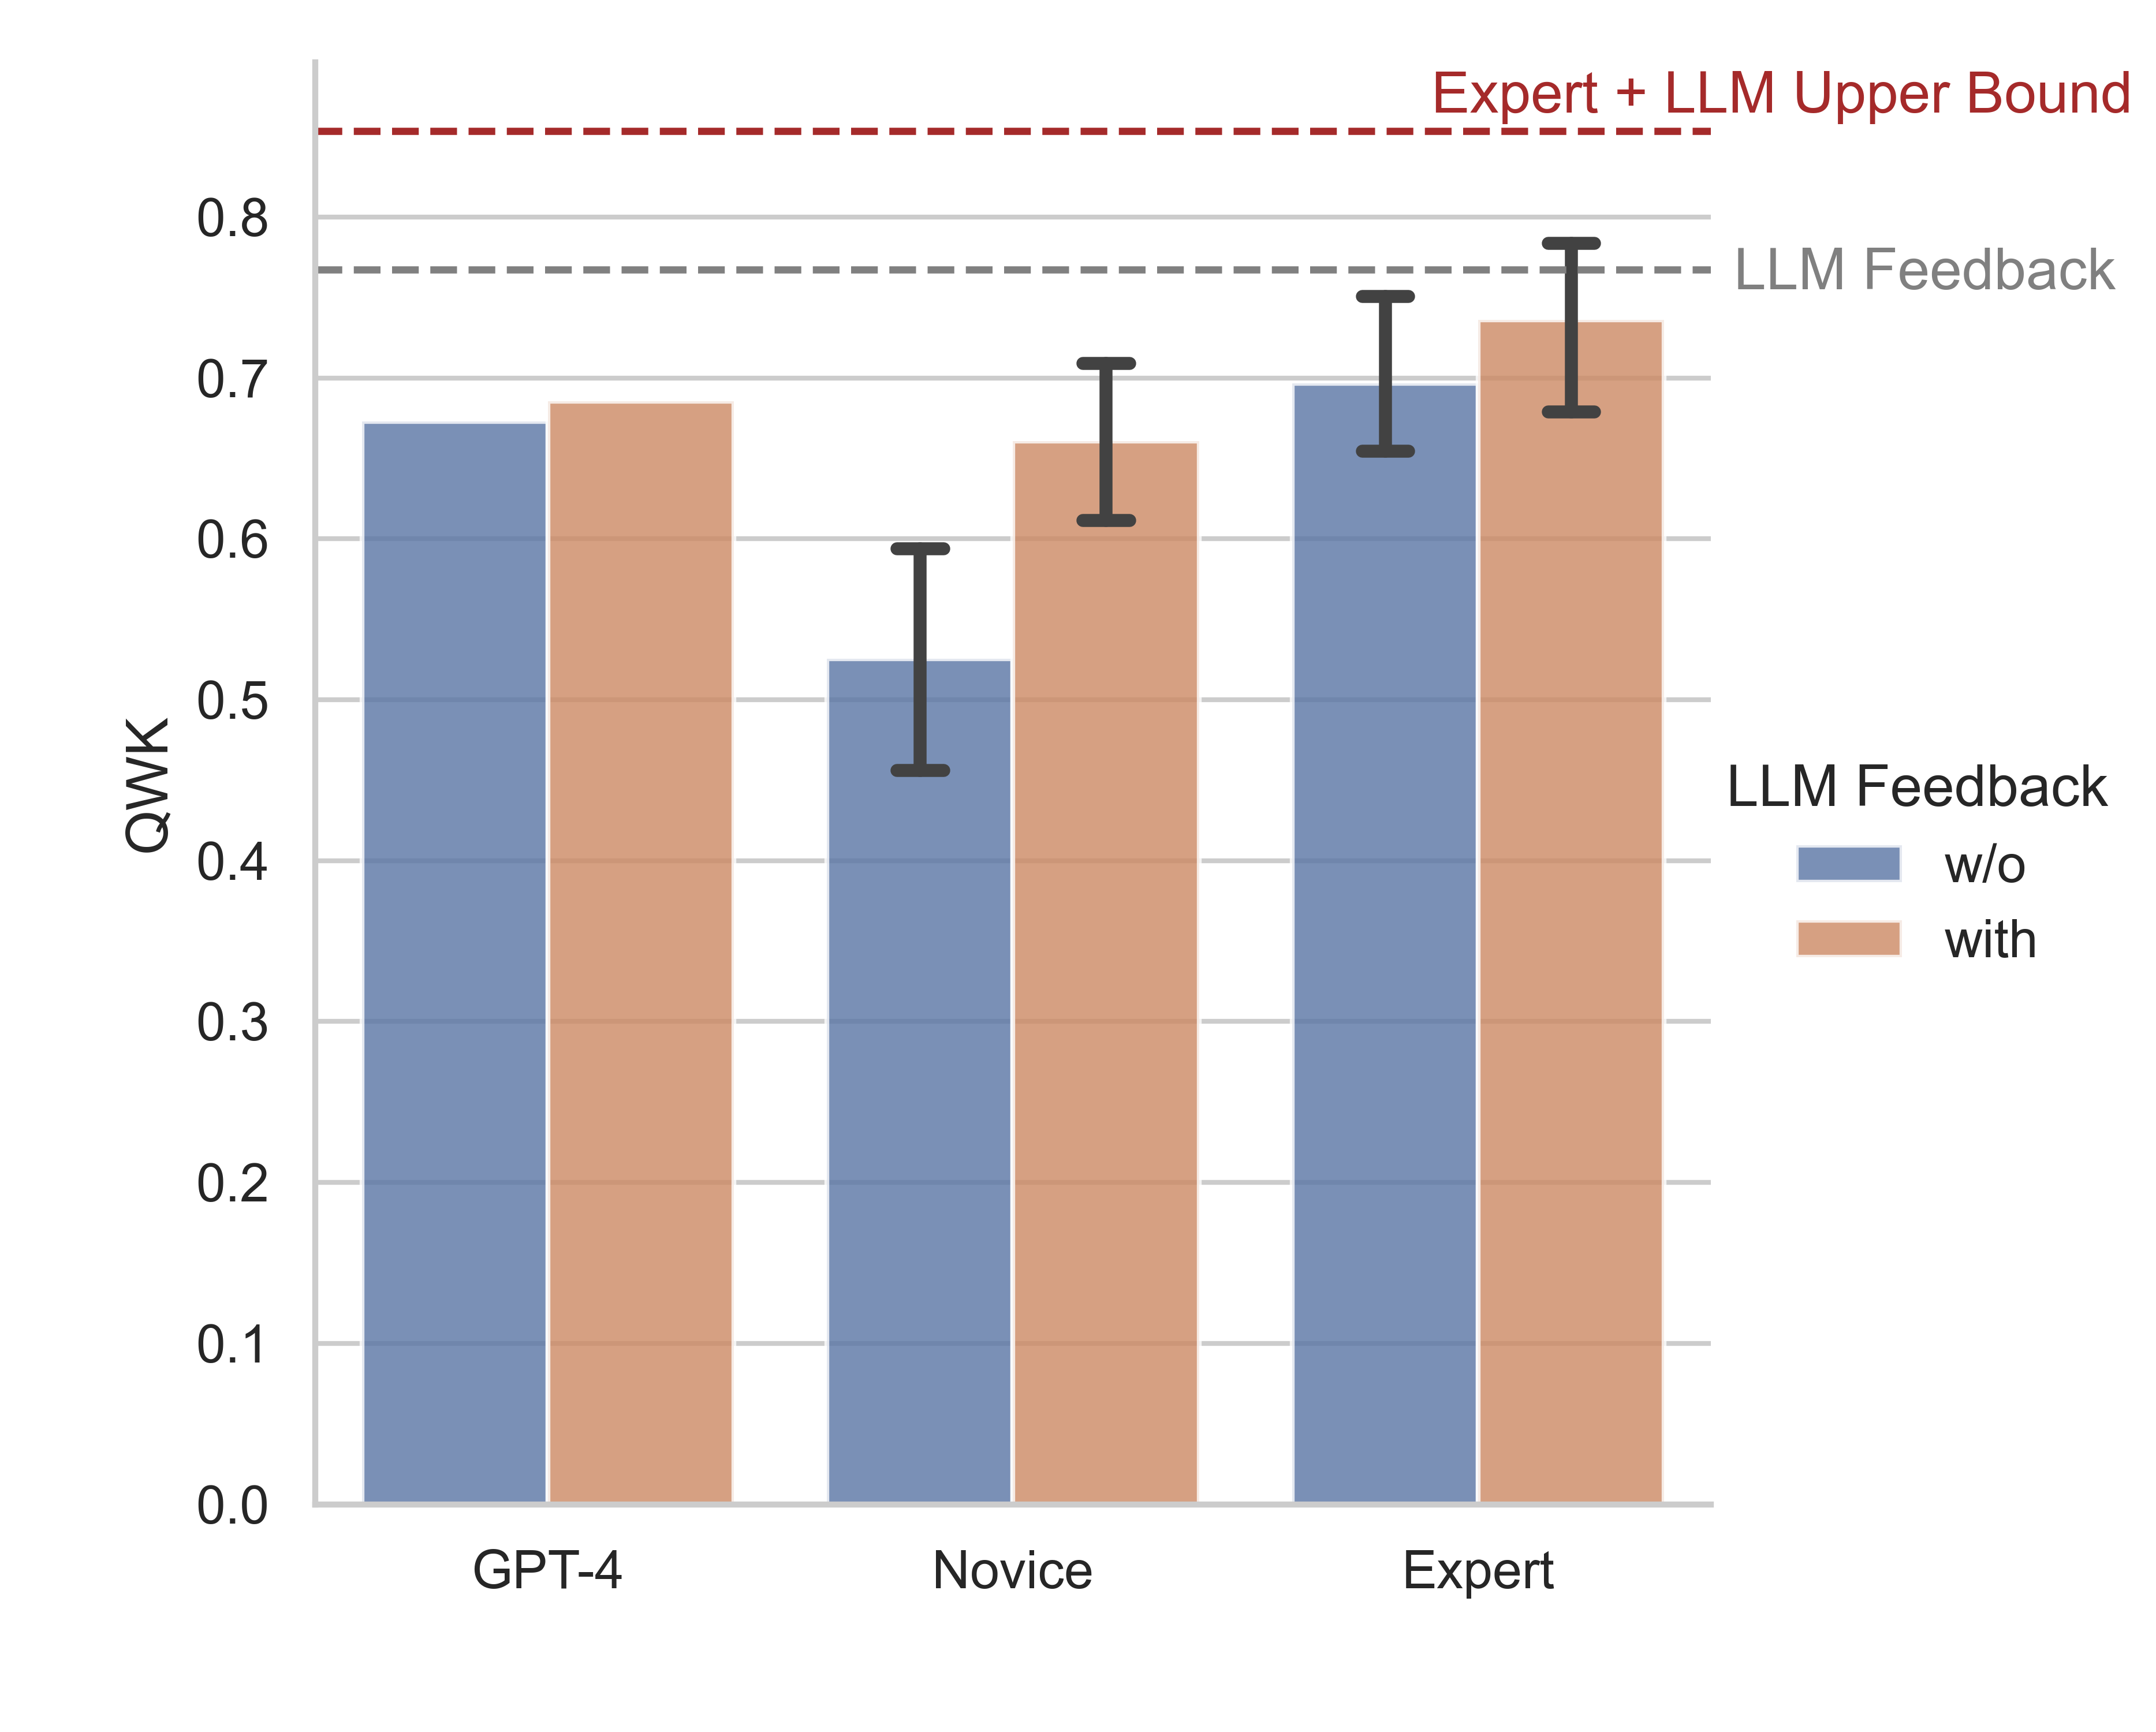
(3) LLM 피드백을 받은 초보 채점자는 전문가와 통계적으로 구별되지 않는 수준에 도달함.
| 비교 | 평균 차이 | p값 |
|---|---|---|
| 전문가 vs 초보 | 0.1709 | 0.0109 |
| 초보+LLM vs 초보 | 0.1353 | 0.0098 |
| 전문가+LLM vs 전문가 | 0.0395 | 0.3699 |
| 초보+LLM vs 전문가 | -0.0356 | 0.4284 |
- 초보의 평균 QWK는 0.5256에서 0.6609로 올랐고, 전문가 평균 0.6965와 유의한 차이가 없었음.
- 전문가는 0.6965에서 0.7360으로 올랐지만 유의하지 않았음. 대신 채점 시간이 줄었다고 응답했고, 특히 언어 차원에서 전문가 간 점수 편차가 줄어 합의도가 높아짐.
(4) 바꾼 횟수보다 바꾼 판단의 질이 달랐음.
| 집단 | 점수를 바꾼 비율 | 바꾼 경우 중 개선 비율 |
|---|---|---|
| 초보 | 69.5% | 60% |
| 전문가 | 26% | 84.6% |
- 초보는 LLM 점수를 자주 따랐지만 열에 넷은 오히려 나빠졌음. 전문가는 확신이 있는 곳에서는 자기 판단을 지키고, 고친 경우는 대부분 정답에 가까워짐.
- 어떤 집단도 미세조정 GPT-3.5 자체의 성능을 넘지 못했고, 각자의 상한선(전문가 한 명의 경우 QWK 0.8020)에도 미치지 못했음.
(5) 전문가가 매긴 시스템 평가는 높았음(5점 척도).
| 항목 | 점수 |
|---|---|
| LLM 점수의 정확성(총점·내용·언어·구조) | 4.3 / 4.0 / 3.9 / 3.8 |
| LLM 점수의 유용성 | 4.7 |
| LLM 설명의 유용성 | 4.8 |
| 효율성 | 4.4 |
| 사용 의향 | 4.3 |
(6) GPT-4는 더 나은 피드백을 받아도 거의 나아지지 않았음. 퓨샷 GPT-4의 총점 QWK는 0.6729로 전문가 수준이었지만, 미세조정 모델의 점수와 설명을 받은 뒤에도 의미 있는 향상이 없었고 내용·언어 차원에서는 오히려 조금 떨어졌음. 외부 정보를 비판적으로 걸러 자기 판단을 고치는 능력에서는 인간이 앞섬.
4. 결론 및 시사점
(1) 맥락과 루브릭, 좋은 예시를 갖추면 GPT-4도 쓸 만한 채점을 하지만, 정확도는 과제 데이터로 미세조정한 모델이 가장 높았음. 범용 모델에 루브릭만 붙이는 방식으로는 학교 평가 기준을 재현하기 어렵다는 뜻임.
(2) LLM의 진짜 가치는 점수와 함께 나오는 설명에 있음. 설명을 받은 초보 채점자가 전문가 수준에 도달하고 전문가는 더 빠르고 일관되게 채점했다는 결과는 자동 채점을 대체가 아닌 협업 도구로 설계할 근거가 됨.
(3) 다만 인간이 LLM 조언을 얼마나 잘 걸러 쓰느냐가 성패를 가름. 연구진도 인간과 LLM 모두 더 나은 참조 점수를 넘어서지 못한 이유와, 이를 끌어올릴 설계 전략을 후속 과제로 남김.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 가장 주목할 결과는 평균 QWK가 아니라 수정 행동표임. 초보는 69.5%를 고쳐 60%만 좋아졌고, 전문가는 26%만 고쳐 84.6%가 좋아졌음. 초보의 향상은 판단력이 생겨서라기보다 대체로 더 정확한 기계 점수 쪽으로 끌려간 결과일 가능성이 큼. 초보+LLM이 전문가와 통계적으로 같았다는 문장만 보고 신규 채점자 연수를 줄이면 안 되는 이유임. 기계가 틀리는 날 초보는 함께 틀림.
(2) 인접 분야와 연결하면, 이 패턴은 인간공학의 자동화 편향과 같은 모양임. 의사결정 보조 시스템 연구에서 경험이 적은 사용자일수록 자동 권고를 과신하는 현상이 반복 보고돼 왔음. 학교 서·논술형 채점에 LLM을 붙인다면, 교사가 먼저 독립 채점하고 그다음 LLM 점수를 여는 순서, 그리고 점수 차가 클 때만 설명을 읽게 하는 장치가 필요함. 이 연구의 실험 설계(1차 독립 채점 후 2차 수정)가 그 자체로 좋은 운영 모델임.
(3) 발전 아이디어는 세 가지임.
- 첫째, LLM 점수 대신 설명만 보여 주는 조건을 추가함. 숫자 닻이 없을 때도 초보가 나아지는지 보면 학습 효과와 추종 효과를 분리할 수 있음.
- 둘째, LLM이 일부러 틀린 점수를 섞은 조건에서 집단별 탐지율을 측정함. 오류를 걸러 내는 능력이 곧 채점 전문성의 정의가 될 수 있음.
- 셋째, 한국 교육과정평가원이 추진해 온 서·논술형 자동채점처럼 한국어 데이터에서도 미세조정 모델과 범용 모델의 격차가 같은 크기로 나타나는지 재현함.
6. 추가 탐구 질문
(1) LLM 피드백과 함께 수십 편을 채점한 초보 채점자는 LLM 없이 채점할 때도 실력이 남아 있는가?
(2) 루브릭 해석이 갈리는 구조·논리 차원에서 LLM 설명은 교사 간 합의를 높이는가, 아니면 LLM의 해석으로 판단을 획일화하는가?
(3) 미세조정 모델의 점수를 받은 GPT-4가 개선되지 않은 것처럼, 여러 AI의 판단을 겹쳐 쓰는 다중 에이전트 채점은 어떤 조건에서 실제로 정확도를 높이는가?
출처
- Xiao, C., Ma, W., Xu, S. X., Zhang, K., Wang, Y., & Fu, Q. (2024). From automation to augmentation: Large language models elevating essay scoring landscape (Version 1). arXiv preprint arXiv:2401.06431. https://arxiv.org/abs/2401.06431v1
- 이후 개정판: Xiao, C., Ma, W., Song, Q., Xu, S. X., Zhang, K., Wang, Y., & Fu, Q. (2025). Human-AI collaborative essay scoring: A dual-process framework with LLMs. Proceedings of the 15th International Learning Analytics and Knowledge Conference (LAK ‘25). https://doi.org/10.1145/3706468.3706507