777 / 780
챗GPT의 글쓰기 피드백은 숙련 교사의 피드백과 얼마나 다른가?
1. 연구의 목적
(1) 초고에 주는 형성적 피드백은 글쓰기 발달을 끌어올리는 대표적인 수업 실천임. 문제는 비용임. 이 연구의 바탕이 된 원래 개입에서는 교사 한 명이 글 한 편에 피드백을 쓰는 데 연수 시간을 포함해 약 20~25분이 들었음. 학급 단위로 자주 피드백을 돌려주기 어려운 이유가 여기에 있음.
(2) 연구진은 별도 훈련 없이 쓰는 챗GPT(GPT-3.5 무료 버전)가 이 부담을 덜 수 있는지 묻고, 같은 학생 글에 대한 교사 피드백과 챗GPT 피드백의 품질을 다섯 기준으로 비교함. 기준은 평가 준거 기반 여부, 개선 방향의 명확성, 정확성, 핵심 요소의 우선순위화, 지지적 어조임.
2. 연구의 방법
(1) 미국 남캘리포니아 2개 학군, 26개 학급(6~12학년) 학생이 쓴 역사 영역 자료 기반 논증문에서 200편을 무작위 추출함. 과제는 델라노 포도 파업과 몽고메리 버스 보이콧 중 하나가 왜 성공했는지 논증하는 것이었음. 표본은 영어 학습자(EL) 50명, 재분류 영어 능숙자(RFEP) 50명, 영어 능숙 학생 100명으로 층화함.
(2) 비교한 두 피드백 출처는 다음과 같음.
| 구분 | 인간 평가자 | 챗GPT |
|---|---|---|
| 주체 | 중등 사회·영어 교사, 작문 연구자, 문식성 교육 대학원생 16명. 12명은 작문 지도 경력 15년 이상 | ChatGPT v3.5, temperature 0.1 |
| 준비 | 3시간 피드백 연수, 루브릭과 피드백 문장 틀 제공 | 중등 교사 역할 부여, 친절하고 격려하는 어조 지시, 과제와 원자료 제공 |
| 분량 지시 | 성장에 가장 도움이 될 요소 중심 | 구체적이고 실행 가능한 피드백 2~3개 |
| 소요 | 글 한 편당 약 20~25분 | 즉시 생성 |
(3) 훈련받은 코더가 학생 글 아래 두 피드백(제시 순서 무작위)을 보고 다섯 기준을 1~5점으로 채점함. 연구 질문은 셋임. 전체 표본에서의 품질 차이, 글 품질(상·중·하)에 따른 차이, 학생의 언어 배경에 따른 차이임. 한 문장도 안 되는 글 2편에는 챗GPT가 피드백을 내지 못해 분석에서 제외함.
3. 주요 발견

(1) 다섯 기준 중 네 개에서 인간이 앞섰고, 평가 준거 기반 항목만 챗GPT가 앞섰음.
| 기준 | 인간 | 챗GPT | 효과크기(Cohen’s d) |
|---|---|---|---|
| 평가 준거 기반 | 3.40 | 3.64 | -0.22 (챗GPT 우위) |
| 개선 방향의 명확성 | 3.65 | 3.27 | 0.41 |
| 정확성 | 4.55 | 4.00 | 0.61 |
| 핵심 요소 우선순위화 | 3.92 | 3.09 | 0.82 |
| 지지적 어조 | 4.28 | 4.02 | 0.32 |
- 격차가 가장 큰 항목은 핵심 요소 우선순위화(0.83점 차)였음. 무엇부터 고쳐야 하는지 고르는 판단에서 숙련 교사의 강점이 뚜렷함.
- 그래도 모든 기준에서 두 집단의 차이는 1점 이내였고, 평가자 차이가 설명하는 분산(부분 에타제곱)은 .01~.12로 작았음. 챗GPT 피드백의 평균은 3.09~4.02점 범위였음.
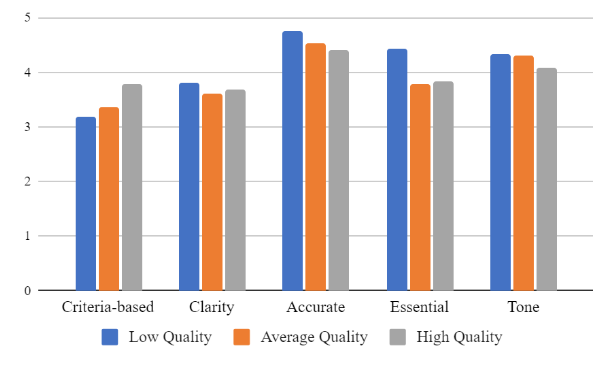
(2) 글 품질에 따라 챗GPT 피드백의 성격이 달라졌음.
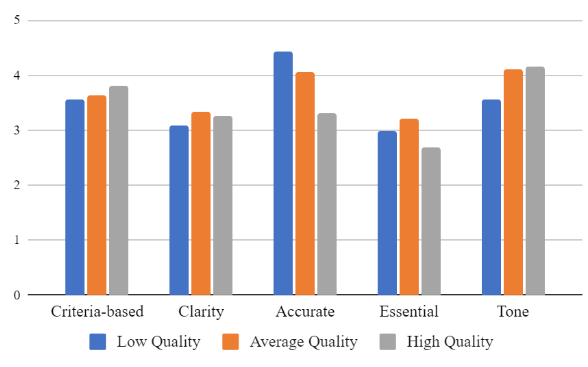
| 기준 | 하: 인간 | 하: 챗GPT | 중: 인간 | 중: 챗GPT | 상: 인간 | 상: 챗GPT |
|---|---|---|---|---|---|---|
| 평가 준거 기반 | 3.19 | 3.56 | 3.36 | 3.63 | 3.78 | 3.81 |
| 개선 방향의 명확성 | 3.81 | 3.08 | 3.60 | 3.33 | 3.69 | 3.25 |
| 정확성 | 4.75 | 4.42 | 4.53 | 4.05 | 4.41 | 3.31 |
| 핵심 요소 우선순위화 | 4.44 | 2.98 | 3.79 | 3.22 | 3.84 | 2.69 |
| 지지적 어조 | 4.33 | 3.56 | 4.31 | 4.10 | 4.09 | 4.16 |
- 챗GPT는 정확성, 우선순위화, 어조에서 글 품질에 따라 통계적으로 유의한 차이를 보임. 정확성은 글이 좋을수록 떨어져 상위 글에서 3.31점까지 내려감.
- 지지적 어조는 하위 글에서 3.56점으로 가장 낮았음. 도움이 가장 필요한 학생이 가장 덜 따뜻한 피드백을 받은 셈임.
- 인간은 우선순위화에서만 유의한 차이를 보였는데, 하위 글에서 4.44점으로 오히려 가장 높았음. 숙련 교사는 약한 글일수록 손댈 곳 하나를 정확히 골라 줌.
(3) 학생의 언어 배경에 따른 차이는 없었음. 영어 능숙 학생과 EL·RFEP 학생이 받은 피드백 품질은 인간과 챗GPT 모두 통계적으로 다르지 않았음.
(4) 사례 분석은 챗GPT 피드백이 어떻게 실패하는지 구체적으로 보여 줌.
- 사실 오류 미탐지: 한 학생이 전단지를 돌린 인물을 로자 파크스로 잘못 썼음(실제로는 조 앤 로빈슨과 그 학생들). 교사는 이를 짚었지만 챗GPT는 원자료를 모두 받고도 오류를 놓침.
- 자기모순: 챗GPT가 앞에서 학생이 핵심 요인을 잘 짚었다고 칭찬한 뒤, 파크스의 행동만이 성공 요인은 아니라는 점에 유의하라고 덧붙여 칭찬과 충돌함.
- 모호한 표현: 다른 사례에서 둘 다 근거 보강을 권했지만, 교사는 원자료의 증거라는 준거 언어를 쓴 반면 챗GPT는 예시라는 막연한 표현을 씀.
4. 결론 및 시사점
(1) 잘 훈련되고 보수를 받으며 시간 여유가 있던 숙련 평가자가 GPT-3.5보다 나은 피드백을 줬음. 연구진이 강조하는 요점은 반대편에 있음. 훈련 없이 즉시 생성된 피드백이 숙련 교사와 1점 이내 차이까지 따라왔다는 점임. 자동 피드백 품질이 낮아 이런 비교 자체가 무의미했던 과거와 대비되는 결과임.
(2) 활용 지점은 초고 단계와 숙련 교사가 없는 상황임. 즉시 돌아오는 피드백은 수정 동기를 살리고 수정 주기를 짧게 만듦. 3점과 4점의 차이가 결정적이지 않은 수업 맥락도 많음.
(3) 조건이 붙음. 챗GPT 피드백은 정확성과 우선순위화가 약하고 글 품질에 따라 흔들리므로, 교사와 학생 모두에게 피드백을 걸러 읽는 AI 리터러시가 필요함. 연구진은 어떤 증거를 넣을 수 있는지처럼 후속 질문을 던져 맞춤 지원을 끌어내는 사용법도 제안함. 하위 글에 대한 어조 문제는 제안형 문장 틀을 프롬프트에 넣어 보완할 여지가 있다고 봄.
5. 리뷰어의 ADD(+) One: 생각 더하기
(1) 가장 주목할 숫자는 평균이 아니라 글 품질별 정확성 곡선임. 챗GPT는 하위 글 4.42점에서 상위 글 3.31점으로 떨어졌음. 개선점 2~3개를 반드시 내라는 지시가 고칠 곳이 적은 글에서 무리한 지적을 낳았을 가능성이 큼. 프롬프트의 분량 지시가 품질을 깎는 변수일 수 있다는 뜻이며, 잘 쓴 글에는 강점 확인과 심화 질문으로 전환하라는 분기 지시가 필요함.
(2) 인접 분야와 연결하면, 이 결과는 피드백 수준 구분과 맞물림. 해티와 팀펄리(2007)의 틀로 보면 챗GPT는 과제 수준의 지적에 강하고, 무엇을 먼저 할지 정하는 과정 수준의 판단에서 약함. 핵심 요소 우선순위화 격차(d=0.82)가 바로 그 지점임. 교사가 AI 초안 위에서 집중할 일은 문장 다듬기가 아니라 이 학생에게 지금 하나만 고르라면 무엇인지 정하는 일임.
(3) 발전 아이디어는 세 가지임.
- 첫째, 같은 설계를 GPT-4급 이후 모델로 재현하고 글 품질별 정확성 곡선이 평평해지는지 확인함.
- 둘째, 피드백 품질 점수가 아니라 실제 수정본의 향상 폭을 결과 변수로 삼음. 좋은 피드백 점수가 좋은 수정으로 이어지는지는 아직 열려 있음.
- 셋째, 초등 과학 탐구 보고서처럼 원자료 대조가 중요한 장르에서 사실 오류 탐지율을 따로 측정함. 원자료를 모두 주고도 인물을 혼동한 사례는 사실 확인을 AI에 맡기기 어렵다는 신호임.
6. 추가 탐구 질문
(1) 챗GPT 피드백을 받은 학생의 수정본은 교사 피드백을 받은 학생의 수정본만큼 나아지는가?
(2) 개선점 개수를 고정하지 않고 글 품질에 따라 분량과 초점을 바꾸도록 지시하면 상위 글의 정확성 하락은 사라지는가?
(3) AI 피드백을 먼저 주고 교사가 우선순위만 덧붙이는 혼합 방식은 교사의 시간을 얼마나 줄이며, 품질은 어디까지 유지되는가?
출처
- Steiss, J., Tate, T., Graham, S., Cruz, J., Hebert, M., Wang, J., Moon, Y., Tseng, W., Warschauer, M., & Olson, C. B. (2024). Comparing the quality of human and ChatGPT feedback of students’ writing. Learning and Instruction, 91, 101894. https://doi.org/10.1016/j.learninstruc.2024.101894